外观
垂直专业领域探索
TraeWork 是字节跳动旗下 AI 办公平台,侧重学习、办公与工程执行场景,无论你是开发者、职场人、学生,都可以用它写方案、做分析、处理文件、推进协作,并完成需要持续执行、检查和产出结果的自动化任务。支持桌面端、网页版和移动端,多端协作,随时发起任务、查看进展、持续推进。
立即下载 TraeWork 桌面端
面向具有专业门槛的行业场景,帮助你在特定领域内完成信息理解、内容生成和辅助分析。
适合法律、医疗、教育、金融、政务等等领域的资料解读、方案撰写和判断支持。
No.82|用 TraeWork 自动搜集投标项目信息
作者:马化云 | 主理人 / OPC 超级个体 | 工具:TraeWork | 阅读约 3 分钟 | 原帖:https://forum.trae.cn/t/topic/171979
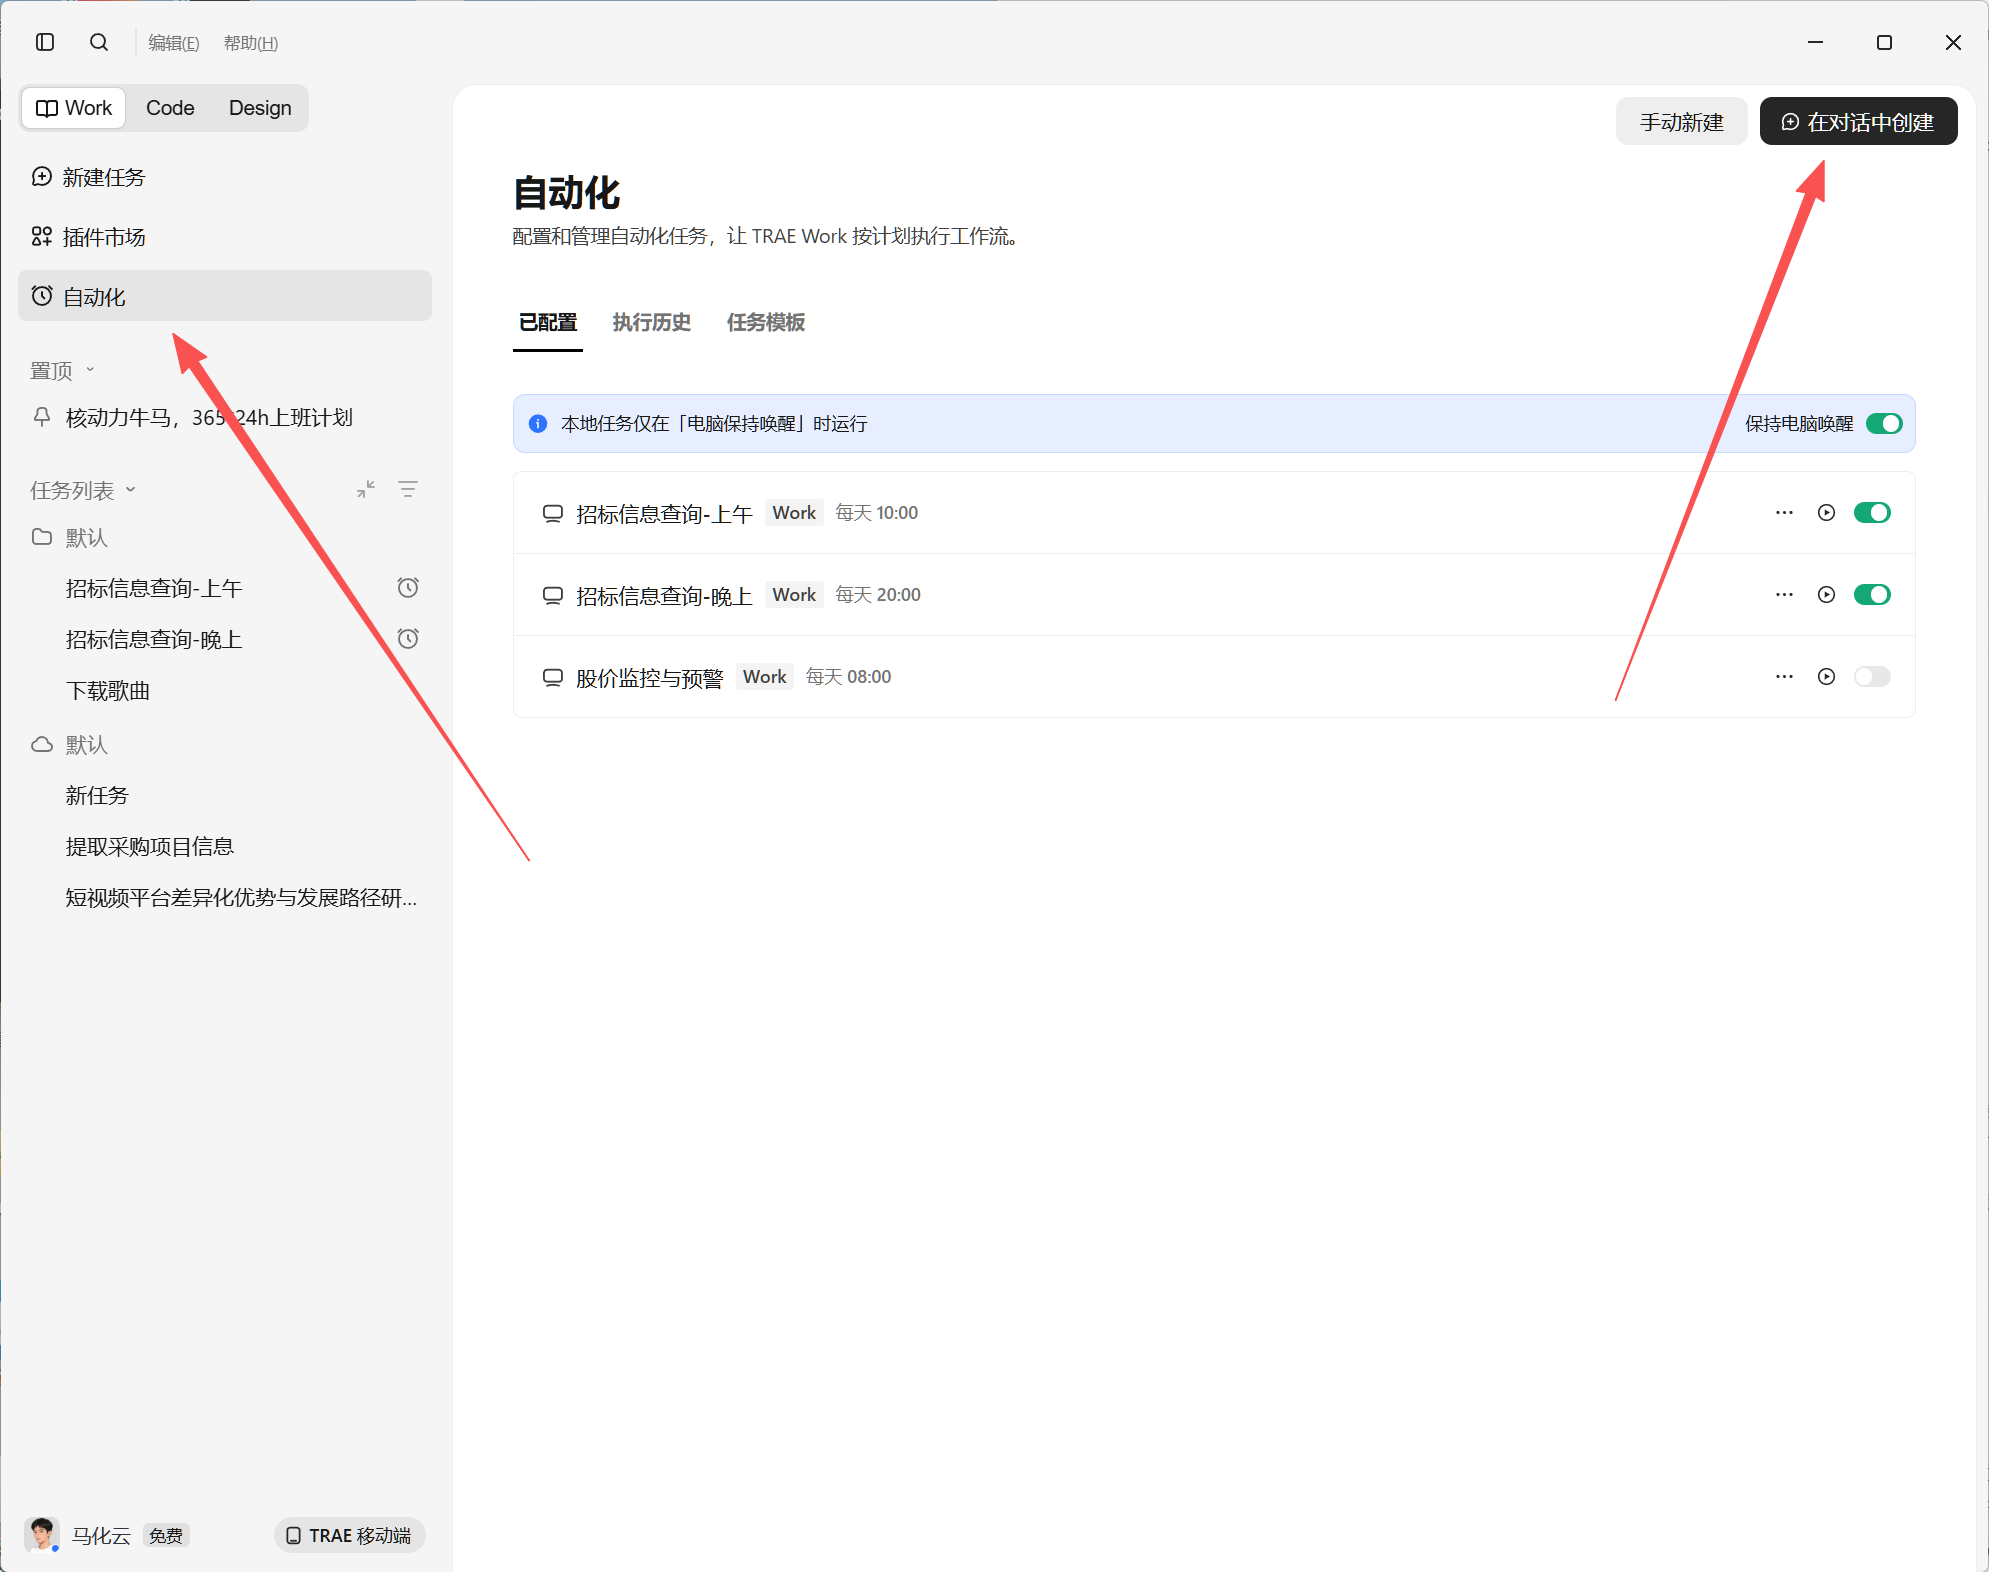
**用法总结:**用【自动化】—【在对话中创建】按模板写清需求,生成定时任务自动搜集投标信息,人工只做筛选。
**场景:**OPC 超级个体找投标项目,手动搜索特别累。
**价值:**把重复性搜集工作交给定时任务无人值守处理,让人腾出时间、把 TraeWork 用成 24 小时工作的超级伙伴。
**成果:**两个定时任务 + 一份自动生成的投标信息报告。
一、个人背景介绍
**个人背景:**主理人 / OPC 超级个体,需要持续寻找合适的投标项目。
**当前痛点:**手动搜索和汇总投标信息重复、耗时,还需要从大量结果中进一步筛选有效项目。
二、我用 TraeWork 怎么解决的
**核心方案:**通过 TraeWork 的自动化任务定时搜集投标信息,把人工工作收敛为结果筛选。
实践步骤:
**进入自动化创建:**点击「自动化」→「在对话中创建」。
**明确搜集要求:**按照系统模板填写关注领域、信息范围、输出格式和执行频率。
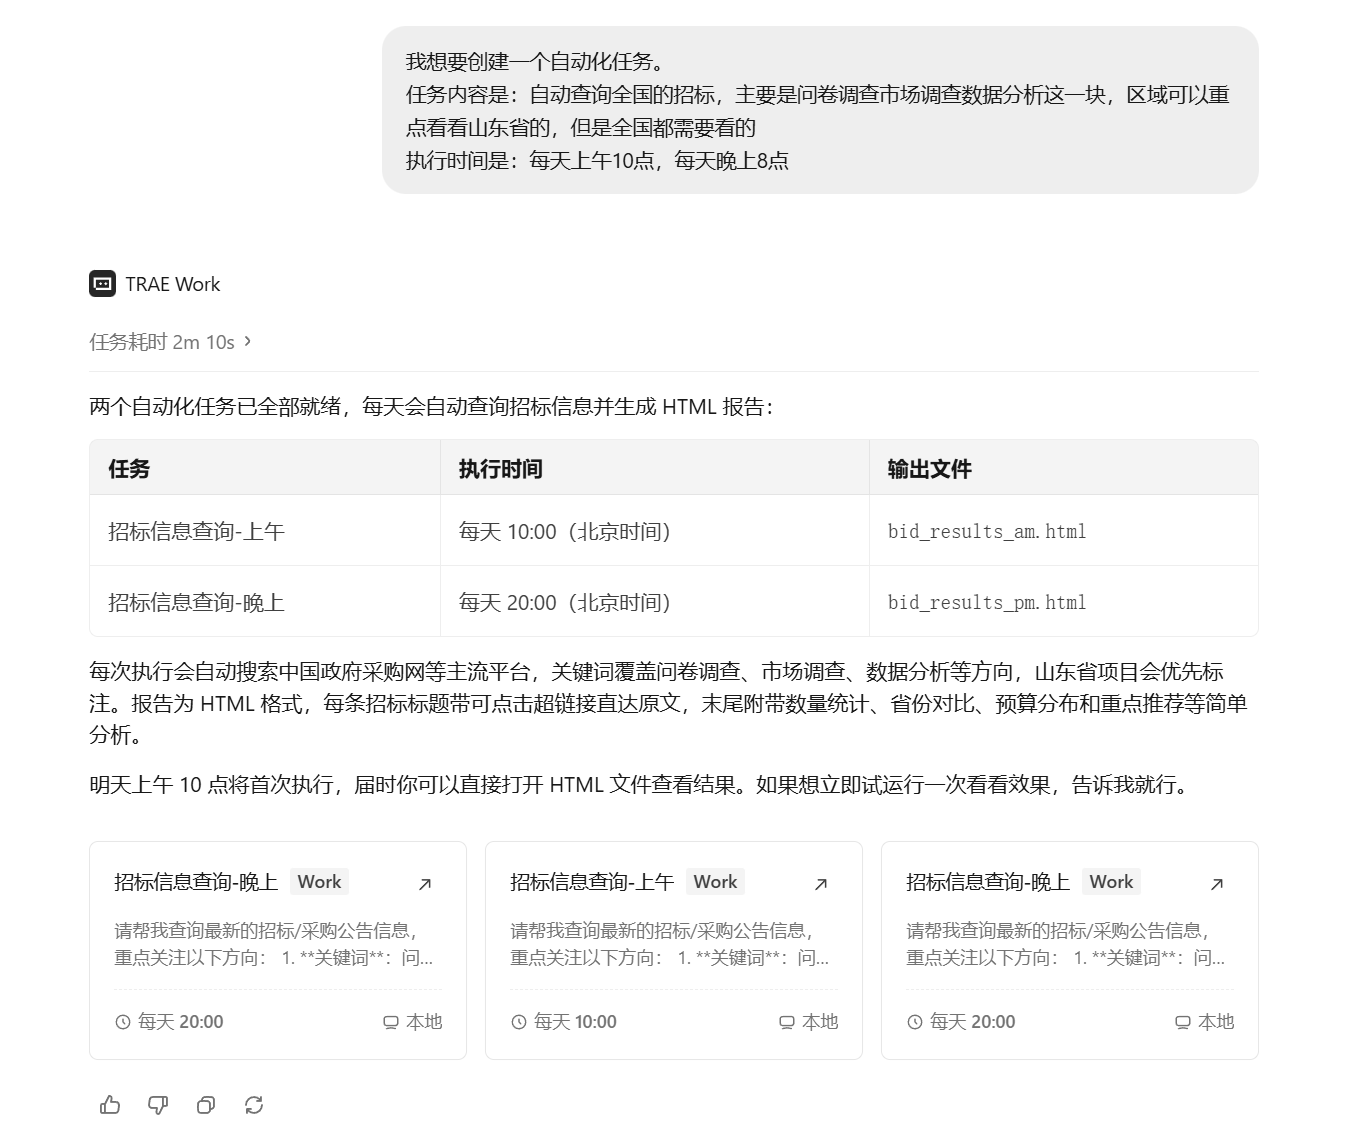
**启动无人值守任务:**生成 2 个定时任务,自动搜集并汇总投标信息。
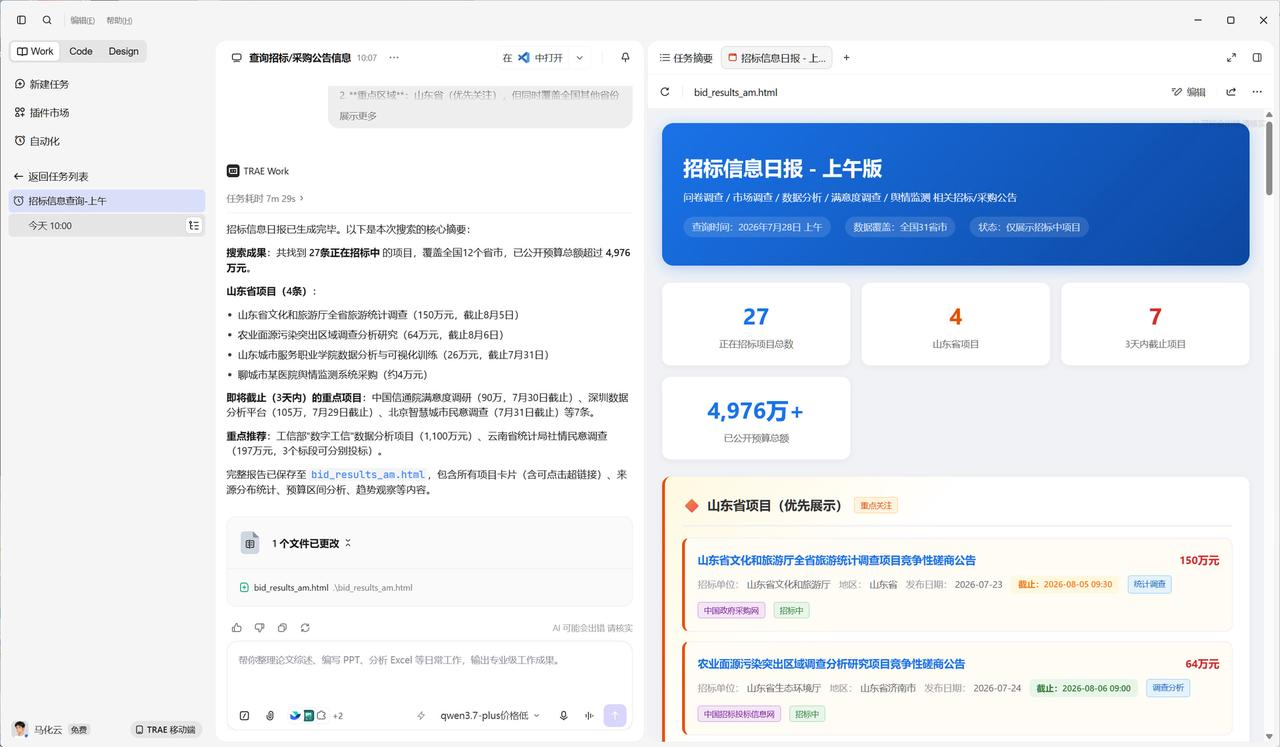
报告演示地址:share.traecontent.cn/artifact/XNIHNTG_G7IXU1。
三、成果展示
最终呈现:
2 个无人值守运行的投标信息定时任务
自动搜集并汇总的投标信息报告
人工只需筛选有效项目的轻量工作流程
四、实践经验总结
1️⃣ 先给它建立记忆、立规矩
比如两次不成功就转别的方法;建立独立工作空间,同类任务在空间里会一并记住处理,越来越聪明。
2️⃣ 搭建任务衔接流程与中转层
把 TraeWork 当作自己的系统慢慢按意愿搭起来,用定时任务、专项任务解决重复性内容。
3️⃣ 搭建只读知识库
用于处理表格、发票、事件等内容,把重复工作交给它,自己就能去追剧了。
五、提示词
Plain
我想要创建一个自动化任务。
任务内容是:自动查询全国的招标,主要是问卷调查市场调查数据分析这一块,区域可以重点看看山东省的,但是全国都需要看的
执行时间是:每天上午10点,每天晚上8点
No.83|用 TraeWork 并行解读多份医保政策文件
作者:u3833375825083225 | 东莞市定点医疗机构医保业务经办人员 | 工具:TraeWork | 阅读约 4 分钟 | 原帖:https://forum.trae.cn/t/topic/172189
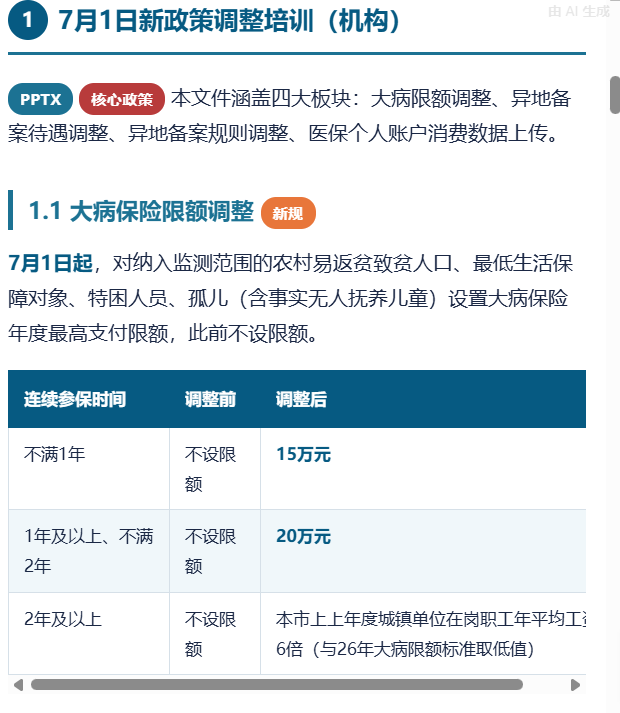
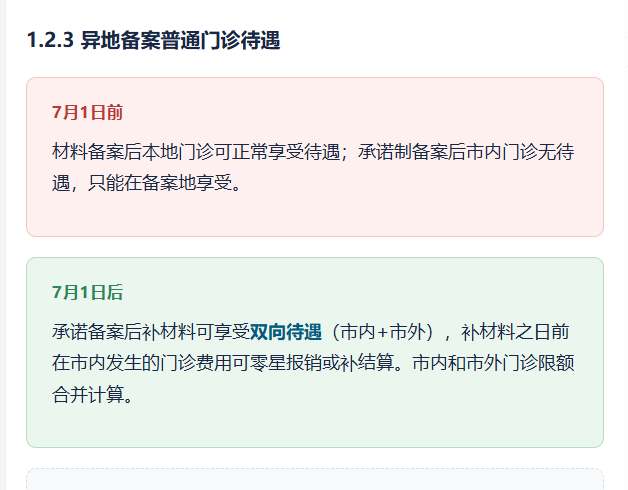
**用法总结:**把 PPT/PDF/Excel 多份培训文件一次性丢给 TraeWork,用多文件解析 + 长上下文 + 结构化输出,生成带前后对比表和变化汇总表的可视化 HTML 解读报告。
**场景:**医保政策调整后快速消化培训文件、提炼核心变化并传达给科室。
**效率提升:**处理耗时至少 6 小时 → 不到 30 分钟,减少超过 91%。
**成果:**两份可视化 HTML 解读报告,含核心解读与 13 项政策变化汇总表。
一、个人背景介绍
**个人背景:**东莞市定点医疗机构医保业务经办人员,需要在政策调整后快速消化培训材料并向科室传达核心变化。
**当前痛点:**本次 3 份 PPT/PDF 材料超过百页,并包含上万条数据;人工逐页阅读、对比和整理至少需要一整天。
二、提效前后对比
| 维度 | 使用前 | 使用后 |
|---|---|---|
| 处理方式 | 人工逐页翻阅整理 | AI 批量解析 + 自动生成报告 |
| 耗时 | 至少一整天 | 不到 30 分钟 |
| 产出形式 | 零散笔记 | 带对比表的可视化 HTML 报告 |
三、我用 TraeWork 怎么解决的
**核心方案:**用 Work 模式批量解析 PPT、PDF 和 Excel,利用长上下文完成跨文件对比,再按统一模板输出可视化 HTML 解读报告。
实践步骤:
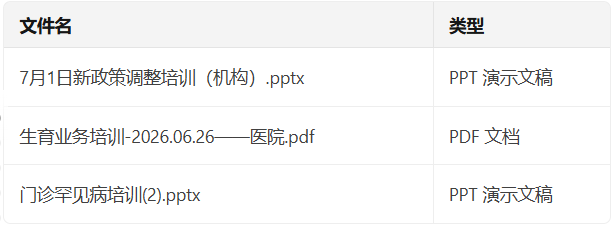
第一步:批量解析文件 把 3 份 PPT/PDF 培训文件丢给它,它自动调用 markitdown 和 PDF 页面提取工具,把所有幻灯片和 PDF 页面的文字内容一次性提取出来,连表格数据都不遗漏。
第二步:深度解读 Excel 数据 DIP 病种目录库是个压缩包,里面有 3 个文件(1 个说明 PDF + 2 个 Excel)。TraeWork 自动解压后用 pandas 读取了 Excel 里的 7 个工作表,比我用 Excel 筛选快得多。
第三步:按模版生成 HTML 报告 告诉它"提取核心内容并列出新文件变化内容",它自动生成了一份带前后对比表、变化汇总表、入组举例的 HTML 报告,配色和专业度都不错。
四、成果展示
最终呈现:
3 份医保政策培训材料的核心解读报告
包含 13 项政策变化的调整前后汇总表
统一配色、带目录导航和数据卡片的 2 份可视化 HTML 报告
五、实践经验总结
1️⃣ 压缩包先解压再投喂
TraeWork 能自动解压 zip 和 tar 文件,但 tar 包里中文文件名可能有编码问题,用 Python 的 tarfile 库处理更稳。
2️⃣ 给出明确模板
第一次让它"提取核心内容并列出变化"效果就不错,但若给出更具体的输出模板(如"前后对比表 + 标签分类"),生成质量会更高。
3️⃣ 同一会话内保持风格一致
第二份报告直接说"按这模板写",它会沿用之前的配色和布局风格,省去重复描述样式的时间。
六、提示词参考
请帮我解读以下文件,提取核心内容并列出新文件变化内容。
Plain
请帮我解读以下文件,提取核心内容并列出新文件变化内容。
输出要求:
1. 每份文件分别解读,提取核心政策要点
2. 用"调整前 vs 调整后"对比表展示变化
3. 最后汇总所有变化点,标注类型(新增/优化/收紧)
4. 生成一份 HTML 报告,含目录导航、数据统计卡片、对比表格
No.84|用 TraeWork 搭建行政采购工作台
作者:LEIINX | 行政采购从业者 | 工具:TraeWork | 阅读约 5 分钟| 原帖:https://forum.trae.cn/t/topic/172260
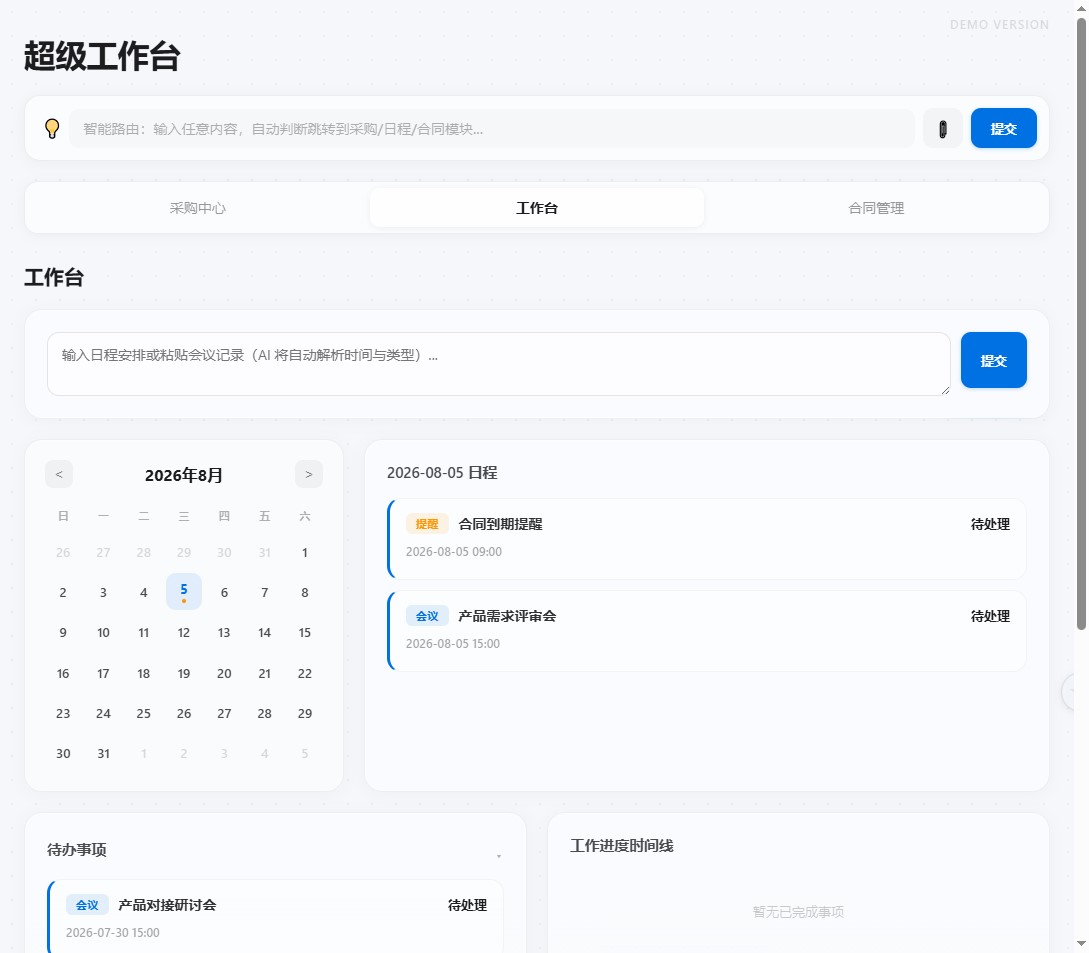
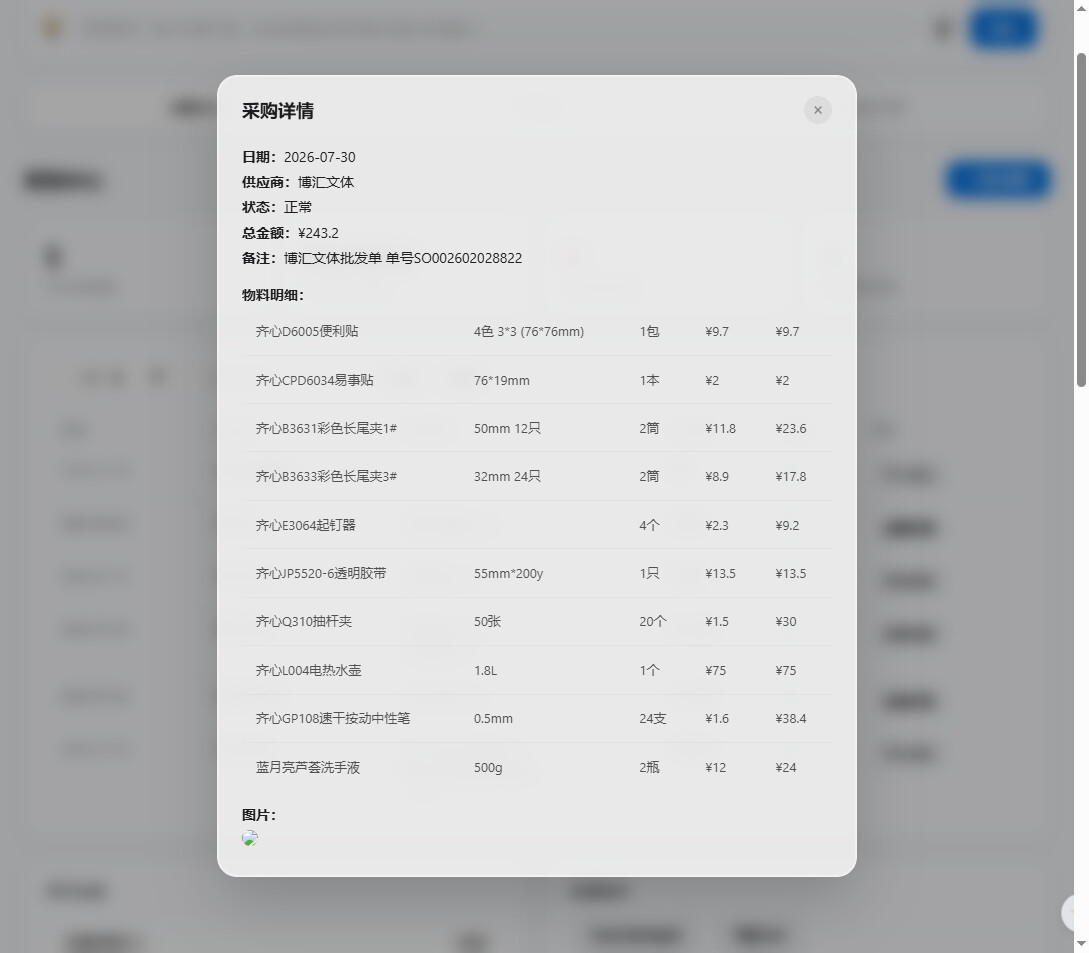
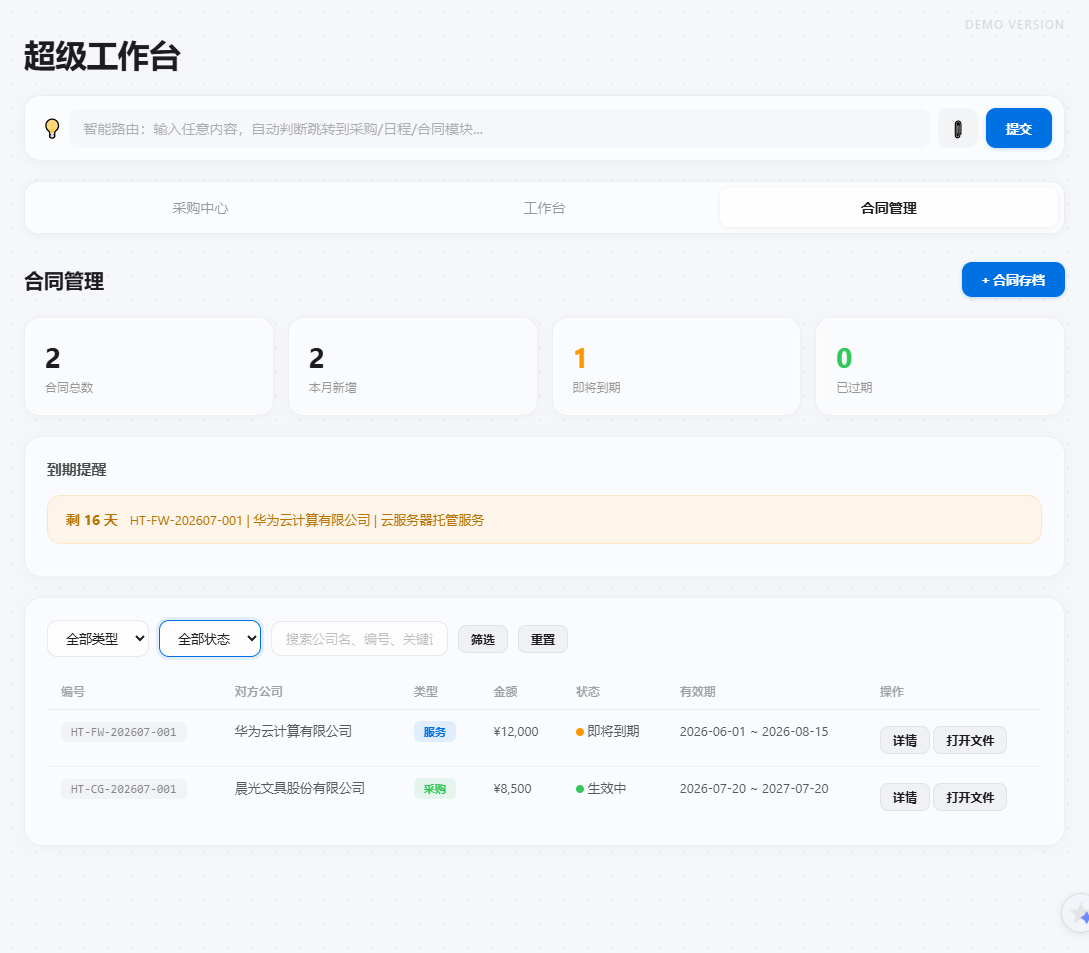
**用法总结:**创建三个 Skill 分管采购、日程、合同,再用 Trae Code 搭可视化 Web 前端整合成一个「超级工作台」,三者共享同一数据文件。
**场景:**行政采购日常要同时管采购记账、日程会议、合同存档三摊零碎活。
效率提升:采购从拍照到入库 10 秒,月度对账从半天变成一键生成,月报从憋两小时变成一键输出。
**成果:**一个入口管完三摊杂事的个人超级工作台:拍单入库、说话排日程、甩合同自动审核存档。
一、个人背景介绍
**个人背景:**我是做行政采购相关工作的,日常要同时管三摊事:采购记账、日程会议、合同存档。每件都不难
**当前痛点:**但加在一起就是无穷无尽的零碎活——采购单月底拼着对账要半天,会议纪要写完就忘,合同到期了才发现还没续签。市面上的工具要么太重,要么只解决其中一个点。
二、提效前后对比
| 场景 | 以前 | 超级工作台 |
|---|---|---|
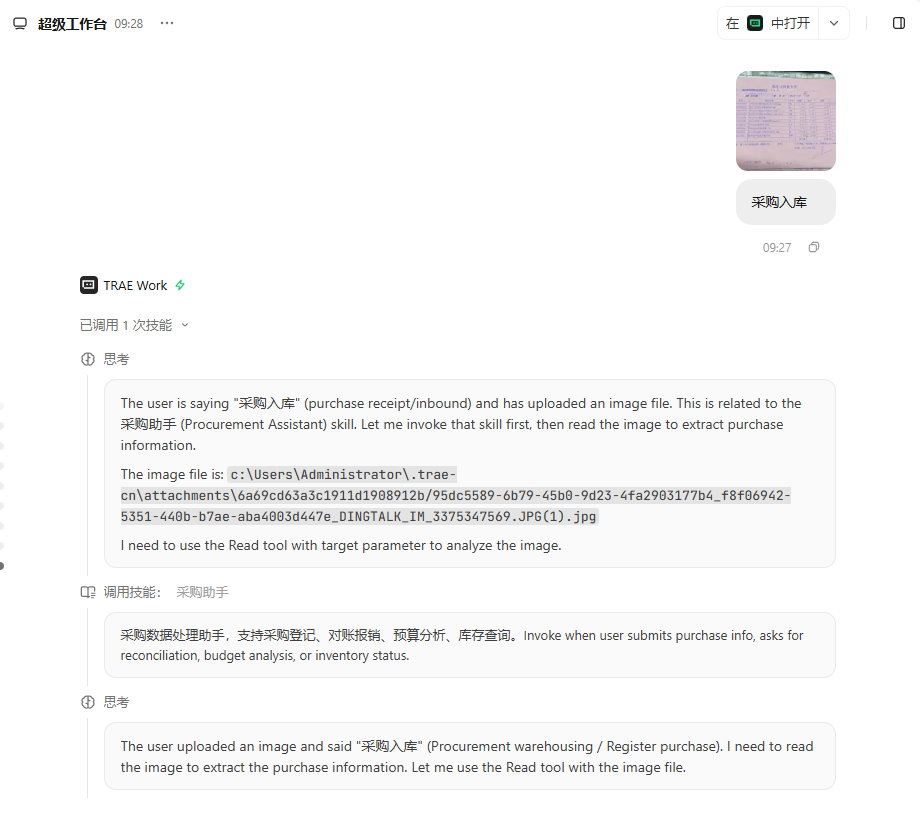
| 采购入库 | 手工录入 | 拍照识别 10 秒入库 |
| 月度对账 | 拼着对账要半天 | 一句「对账」一键生成 |
| 月报 | 凭回忆憋两小时 | 一键汇总输出 |
| 合同 | 到期才发现没续签 | 审核+编号+存档流水线,临期提醒 |
三、我用 TraeWork 怎么解决的
**核心方案:**核心思路是:三个 Skill 共享同一个数据文件,前端负责展示,Skill 负责干活。
实践步骤:
**搭建前端工作台(Trae Code):**要有三个 Tab 页包括采购中心、工作台、合同管理。顶部有一个全局智能输入框,输入「登记采购」自动跳到采购页,输入「周三下午3点开会」自动跳到日程页,输入「合同存档」自动跳到合同页。
**创建三个 TraeWork Skill:**采购助手(拍单识别物料/数量/单价、超标预警、对账预算)、工作台助手(自然语言排日程、会议摘要、月报)、合同管理助手(审核风险点、自动编号存档、到期提醒)。
**打通数据链路:**三个 Skill 与前端通过同一个 data.json 桥接,Skill 写入数据、前端刷新即见,用 Node.js 写轻量本地服务器做中间层,零依赖。
四、成果展示
最终呈现:
**主交付物:**一个入口管完三摊杂事的个人超级工作台:拍单入库、说话排日程、甩合同自动审核存档。
**效率表现:**采购从拍照到入库 10 秒,月度对账从半天变成一键生成,月报从憋两小时变成一键输出。
五、实践经验总结
1️⃣ Skill 要拆不要合
采购的图片识别、日程的时间解析、合同的条款审核处理逻辑完全不同,塞一起 Prompt 会互相干扰。拆成三个各自聚焦一个场景,准确率明显提升。
2️⃣ 数据结构先定好再动手
三个 Skill + 前端共用一份数据文件,先把 data.json 完整结构定下来,所有开发围绕它进行,后期对接零返工。
3️⃣ 先用 mock 数据跑通全流程
前端与 Skill 开发可并行,先用返回模拟数据的占位函数把前端交互跑通,等 Skill 单独调试无误后再替换对接,两边互不阻塞。
六、提示词参考
三个 Skill 的核心 Prompt 要点
Plain
Skill A 采购助手:角色为采购数据处理助手,三种模式(登记采购/对账报销/预算分析),价格异常阈值(超历史均价20%预警),指定数据文件路径与字段结构。
Skill B 工作台助手:角色为日程管理和会议记录助手,写清自然语言时间解析规则、会议摘要要求(议题/要点/决议/待办分工)、月报固定结构。
Skill C 合同管理助手:角色为合同管理助手,三阶段工作流(审核→确认→存档),风险分 warning/info 两级,编号规则 HT-类型缩写-年月-序号,到期状态自动管理(30天内 expiring、过期 expired)。
No.85|用 TraeWork 自动进行合规审核
作者:青柠 | 农业产业链合规相关从业者 | 工具:TraeWork | 阅读约 5 分钟| 原帖:https://forum.trae.cn/t/topic/172197
**用法总结:**用长上下文理解 + 文件生成 + 联网检索 + 多步骤编排,把纯文本合规词库重构成结构化 JSON 并打包成可自动审核的 Skill。
**场景:**2000 行农业合规词库只能作知识库调用、无版本管理,2026 年政策更新快、条目易过时。
**效率提升:**一篇文案审核从 40 分钟缩短到 2 分钟。
**成果:**可上传到技能市场的合规审核 Skill(75KB),含 18 个知识库文件、788 条结构化词条。
一、个人背景介绍
**个人背景:**为工作方便,我整理了一份农业产业链合规词库 Markdown 文档,涵盖全链路(广告法、农资、种植养殖、食品加工、直播电商、社媒平台)对外发布文案的合规性审核
**当前痛点:**但只能在 Agent 中作为知识库调用。更头疼的是 2026 年政策更新很快(直播电商新规、GB 7718-2025 禁「零添加」、中药材 GAP 动态摘牌),词库没有版本管理,根本不知道哪些条目已过时。
二、提效前后对比
| 维度 | 改造前 | 改造后 |
|---|---|---|
| 单篇审核耗时 | 约 40 分钟 | 约 2 分钟 |
| 使用方式 | 纯文本词库,仅作知识库调用 | 可上传技能市场,发文案自动扫描 |
| 政策时效 | 无版本管理,条目易过时 | 联网补齐 6 项重大政策更新 |
三、我用 TraeWork 怎么解决的
**核心方案:**模式为 Work + Code,核心能力是长上下文理解 + 文件生成 + 联网检索 + 多步骤编排,分四步:
实践步骤:
**扔进去做全量诊断:**把 2000 行词库上传,让它完整读一遍输出诊断报告,它自己发现了章节编号冲突、合格证法规文号写错等我没注意到的问题。
**联网检索最新政策:**搜索 2025-2026 年农业合规最新政策,补齐 6 项词库缺失的重大更新(GB 7718-2025 禁「零添加」、直播电商监督管理办法、预制菜国标征求意见稿、GAP 基地摘牌等)。
**结构化重构:**把纯文本词库拆成 18 个结构化 JSON,每条词条带 13 个字段(禁用词、严重等级、适用品类、法规依据、违法后果、替换建议、同义词变体等),并行启动 3 个子任务处理上/中/下游,788 条全部标准化。
**生成可调用的 Skill:**按 TRAE 的 SKILL.md 规范生成技能主文件(YAML frontmatter、角色定义、8 步审核流程、标准化输出、自迭代指令集),打包成 zip。
四、成果展示
最终呈现:
**主交付物:**产出一个可直接上传到 TraeWork 技能市场的合规审核 Skill(agri-compliance-skill.zip,75KB),包含 18 个知识库文件、788 条结构化词条。上传后在对话里直接发农业文案,就能自动扫描命中的禁用词并给出法规依据和替换建议。示例:审核「XX农药,高效低毒,对人畜安全无害,零残留,杀灭一切害虫!」,自动命中 4 项禁用(如「对人畜安全无害」→「按说明书使用安全」、「零残留」→「农残检测结果符合国家标准」、「杀灭一切害虫」为绝对化用语等)。知识库结构含 general-banned.json(95 条)、pesticide.json(34 条)、livestock.json(103 条)、land-soil.json(86 条)、livestream.json(19 条) 等共 18 个文件。
**成果补充:**可上传到技能市场的合规审核 Skill(75KB),含 18 个知识库文件、788 条结构化词条。
**效率表现:**一篇文案审核从 40 分钟缩短到 2 分钟。
五、实践经验总结
1️⃣ 大文件要分批喂,别一口气丢
2000 行 Markdown 一次读没问题,但让它「直接优化全文」会输出过长且易截断。正确做法是先让它做诊断报告(HTML),拿到问题清单后再分品类并行处理。
2️⃣ 子任务要给明确的文件清单
并行启动子任务时必须告诉它「你只负责这 6 个文件」,否则两个子任务会生成同名文件互相覆盖。
3️⃣ 让 AI 自己联网查政策更新
直接发指令「搜索 2025-2026 年农业合规最新政策法规变化」,它会自动去政府官网和权威媒体抓取并交叉验证,比人工翻官网快 10 倍。
4️⃣ 生成 JSON 时让它自验格式
每批 JSON 生成完追加「用 python 验证所有 JSON 文件的合法性并统计记录数」,比手动检查靠谱。
六、提示词参考
诊断与结构化重构指令模板
Plain
诊断阶段:
请完整阅读这份农业合规词库文档(约2007行),从以下维度做全量诊断:
1. 结构性问题:章节编号是否一致?信息架构是否清晰?
2. 内容性问题:是否有政策时效性滞后?法规引用是否准确?
3. 可机器化问题:格式是否统一?是否缺少结构化标签?
输出一份诊断报告(HTML格式),包含问题清单和优化方案。

结构化重构:
将以下品类的禁用词/限制词拆解为结构化JSON文件,每条词条必须包含:
term, level(禁用/限制/必须标注), category, stage, scenarios, law, consequence, condition, replacement, note, variants
每个词条至少提供2个同义变体用于模糊匹配。输出到 knowledge/{品类}.json
No.86|用 TraeWork 完成标书分析 & 编写
作者:oyjf518 | 政企项目交付 / 投标技术方案 | 工具:TraeWork | 阅读约 6 分钟| 原帖:https://forum.trae.cn/t/topic/172624
**用法总结:**以「长上下文 + Skill 自动化 + 文件读写」搭建投标方案写作流水线,覆盖招标分析、撰写、修改、MD 转 DOCX 排版、多方案合并五个阶段。
**场景:**一套标书动辄 8 个方案、近百页 A4,需逐条对齐招标评分项,人工撰写与排版耗时且易漏项。
**效率提升:**一套标书从分析到成稿由至少 2 周 压缩到 2~3 天 全链路交付。
**成果:**1 份招标分析报告 + 8 份技术方案 + 诊断报告与待修改清单 + 8 份 DOCX 与 1 份合并投标书 + 1 套可复用 Skill 工具链。
一、个人背景介绍
**个人背景:**作者从事政企项目交付,经常撰写投标技术方案。一套标书涵盖软件技术、总体设计、实施、运维、售后等方方面面,每份方案都要对齐招标文件评分项,缺一项就丢分。核心
**当前痛点:**痛点:招标文件又长又绕、评分标准散落各章节难以逐条对照;方案撰写是纯体力活、易写成换皮模板;改稿比写稿更痛苦;Markdown 转 Word 标准排版坑多;最终还要把 8 个独立方案合并成一本、章节编号需连续。
二、提效前后对比
| 环节 | 传统方式 | TraeWork 工作流 |
|---|---|---|
| 招标分析 | 人工逐条对照评分项,易漏 | AI 提取评分标准 + 生成写作框架 + 诊断报告 |
| 方案撰写 | 手写,易变换皮模板 | 长上下文喂料,按框架逐章写、Mermaid 内嵌 |
| 改稿 | 模糊「再充实一下」 | 结构化待修改清单,逐项打勾追踪 |
| 排版转换 | 手动调 Word 格式、编号踩坑 | md2docx.py 一行命令自动转换 |
| 全流程周期 | 至少 2 周 | 2~3 天 |
三、我用 TraeWork 怎么解决的
**核心方案:**作者用 TraeWork 搭建了分五个阶段的投标方案写作流水线:
实践步骤:
**阶段一 · 招标文件分析:**把招标文件转 Markdown 喂给 TraeWork,提取评分标准、反推写作框架、输出诊断报告。
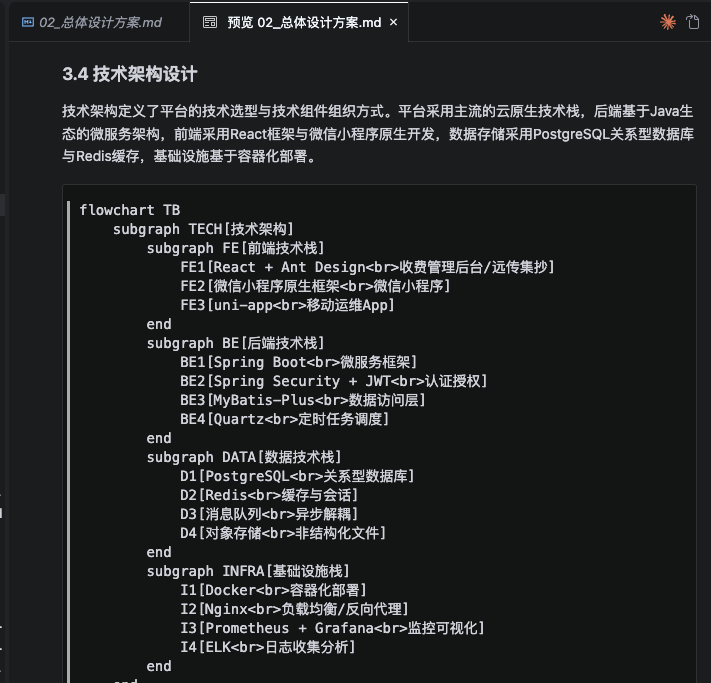
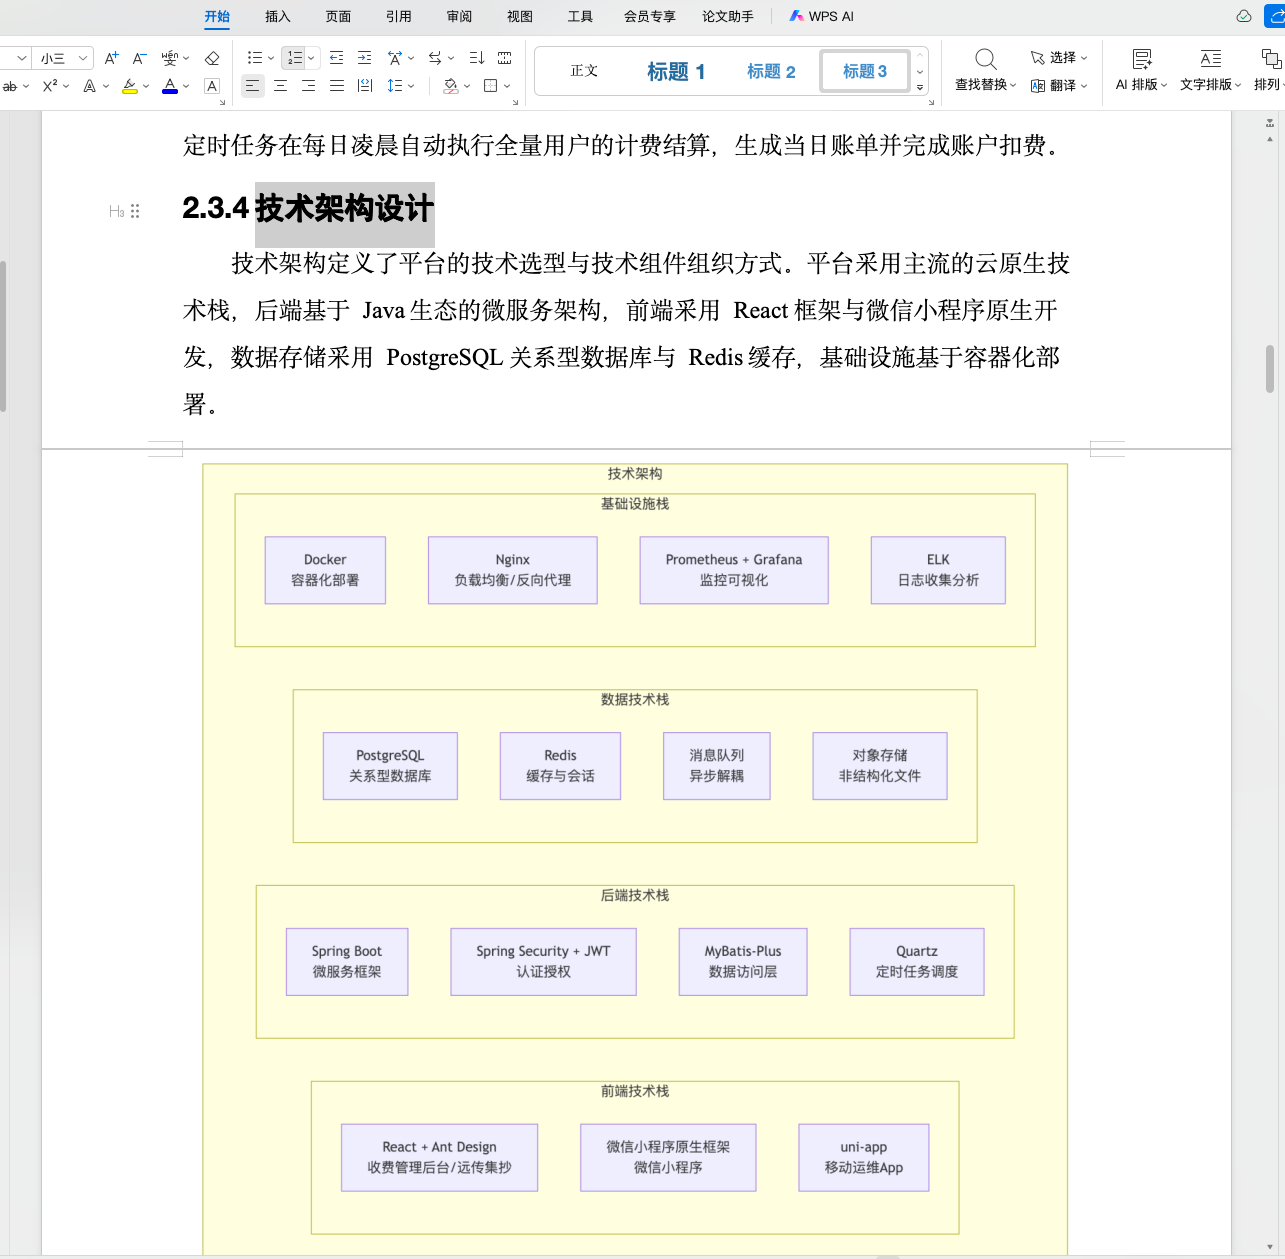
**阶段二 · 方案撰写:**长上下文同时喂招标文件 + 初步方案 + 写作框架;架构图、流程图、时序图用 Mermaid 语法内嵌;8 个方案独立成文件并行推进;用图片生成能力配图。
**阶段三 · 方案修改:**AI 通读全部方案输出「问题诊断与改进指导报告」,为每个方案生成含原文位置、修改建议、优先级的 Todo 清单,逐项修订。
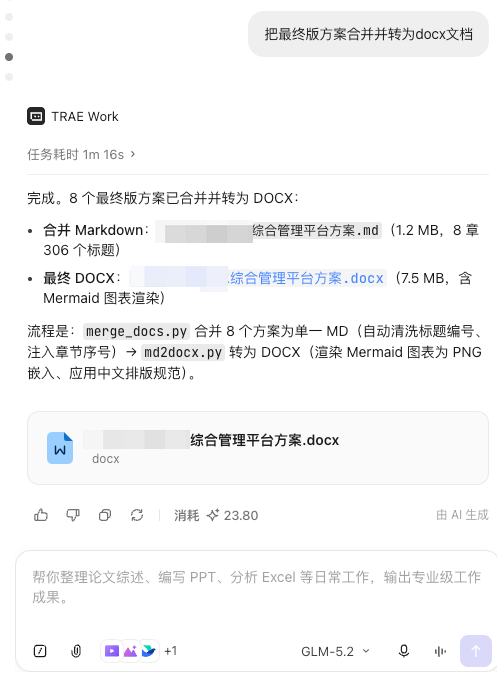
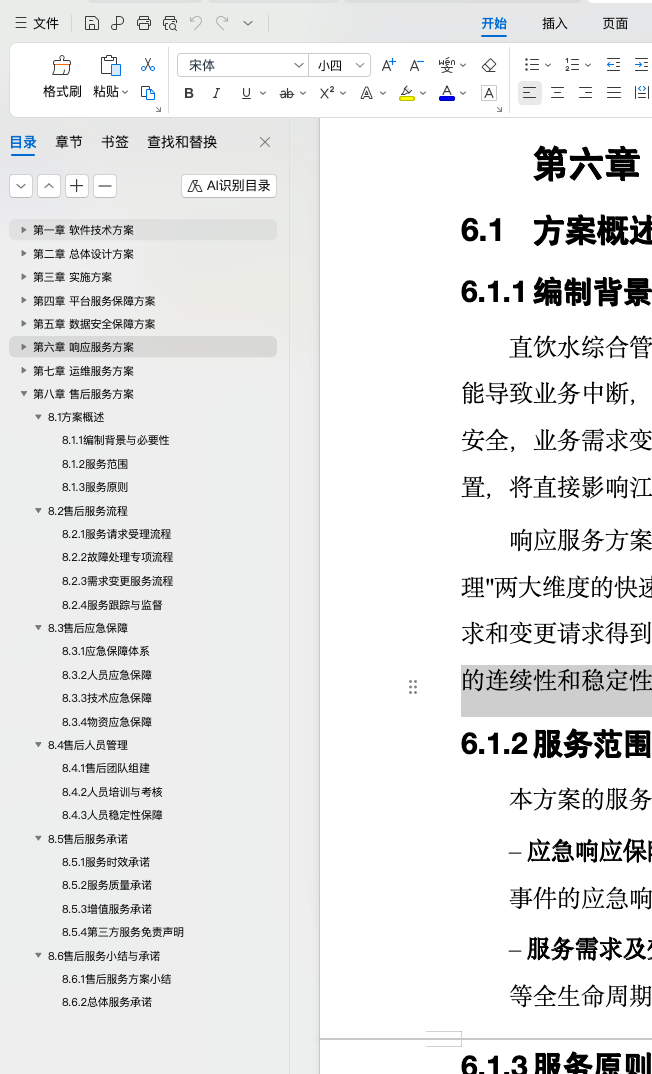
**阶段四 · MD 转 DOCX:**用 Code 模式开发 md2docx.py(Python + python-docx),支持 Mermaid 自动渲染 PNG、黑体标题 / 宋体正文 / 多级编号等中文排版规范,并封装多级标题编号 Skill 与批量转换 Skill。
**阶段五 · 多方案合并:**用 merge_docs.py 与对应 Skill,自动完成标题前缀清洗、章节序号注入、合并为一个 MD 再转 DOCX,解决章节编号连续性问题。
四、成果展示
最终呈现:
**主交付物:**1 份招标分析报告 + 8 份技术方案 + 诊断报告与待修改清单 + 8 份 DOCX 与 1 份合并投标书 + 1 套可复用 Skill 工具链。
**效率表现:**一套标书从分析到成稿由至少 2 周 压缩到 2~3 天 全链路交付。
五、实践经验总结
1️⃣ 先建框架再写正文
让 AI 先从招标文件提取评分标准、生成写作框架,再按框架逐章写,避免自由发挥、对不上评分项。
2️⃣ Mermaid 图表是性价比之王
比手画架构图快 10 倍,MD 源文件可版本管理,转换时自动渲染为 PNG 嵌入 Word 不丢清晰度。
3️⃣ 改稿要用清单驱动
让 AI 先输出结构化待修改清单(原文位置 + 修改建议 + 优先级),再逐项执行,可追踪、不遗漏。
4️⃣ Word 编号是最大的坑
python-docx 默认标题不在导航窗格显示、编号不递增、颜色发蓝。核心是 H1 没链接到隐藏 Level 0 计数器,把 if level >= 2 改为 if level >= 1 即可。
5️⃣ 合并时一定要洗编号
各分方案 MD 自带「1.1」「1.1.1」前缀,合并前必须用正则去掉,否则会与 Word 自动编号叠加。
六、提示词参考
招标文件分析提示词
Plain
你是投标方案架构师。请分析以下招标文件,完成三件事:
1. 评分标准提取:从「评标办法」章节中,逐条提取每个方案的评审内容项、分值、评分规则,输出为表格
2. 写作框架生成:根据评分项反推每个方案的章节结构(一级/二级标题)、预估页数、写作要点
3. 对齐检查:列出每个评分项对应的方案章节,标注「已覆盖/未覆盖」
招标文件如下:
{贴入招标文件全文}
方案撰写提示词
Plain
你是投标技术方案撰写专家。请按以下要求撰写方案:
写作框架:{贴入对应方案的框架}
参考材料:{贴入招标文件技术要求 + 初步方案}
要求:
1. 严格按框架的章节结构撰写,每个评分项必须有对应章节
2. 每个关键设计点用 Mermaid 图表说明
3. 结合项目实际情况,不要写通用模板
4. 语气中性专业,禁止自我评价性语言
5. 输出为 Markdown 格式
方案诊断提示词
Plain
你是投标方案评审专家。请对以下方案进行诊断:
评分标准:{贴入评分项}
方案内容:{贴入方案全文}
请输出:
1. 诊断结论表:方案名 | 分值 | 标题对应度 | 文字充实度 | 主要问题
2. 逐章问题清单:问题项 | 原文位置 | 原文要点 | 修改建议 | 优先级
3. 修改原则:不向甲方做超出合理水平的保证,能删则删,能降则降
No.87|用 TraeWork 搭建跨境法律咨询工作流
作者:u498509467893064 | 企业法律咨询从业者 | 工具:TraeWork | 阅读约 5 分钟| 原帖:https://forum.trae.cn/t/topic/172510
**用法总结:**用 TraeWork 搭"检索-识别-沉淀"三层工作流:tavily/web search/mmx 分区检索、paddleocr 识别 PDF、Obsidian 结构化沉淀,三个工具各管一段串起来用。
**场景:**企业法律咨询,处理境外与中国大陆法律合规问题,长期受"检索散、PDF 卡、案例丢"三大痛点困扰。
**效率提升:**下次遇到同类问题,组合关键词搜索 5 秒 定位过往场景与关键结论;检索命中率与沉淀复用显著提升。
**成果:**一张全球跨境合规流程图、一个 Obsidian 跨境合规知识库、一份工具组合使用规范(团队 SOP)。
一、个人背景介绍
身份:做企业法律咨询,日常处理覆盖境外和中国大陆法律的合规问题。
痛点一(检索散):查境外法律要去法条官网翻资料,搜索→打开链接→二次筛选。
痛点二(PDF 卡):扫描件/影印件的关键条款搜不到。
痛点三(案例丢):做过的项目结论散落在聊天记录、邮件、本地文件夹,下次靠记忆。
二、我用 TraeWork 怎么解决的
**核心方案:**模式:Work。搭建"检索-识别-沉淀"三层工作流,三个工具各管一段:
实践步骤:
**第一层 检索层(tavily 搜索):**境外法律/编程相关优先 tavily search;中国大陆法律用自带 web search;任何兜底用 mmx search。分区检索后境外权威源命中率明显提高。
**第二层 识别层(paddleocr):**PDF 识别优先调用 paddle MCP;普通文本 PDF 直接 paddleocr,扫描件识别后再做结构化提取。
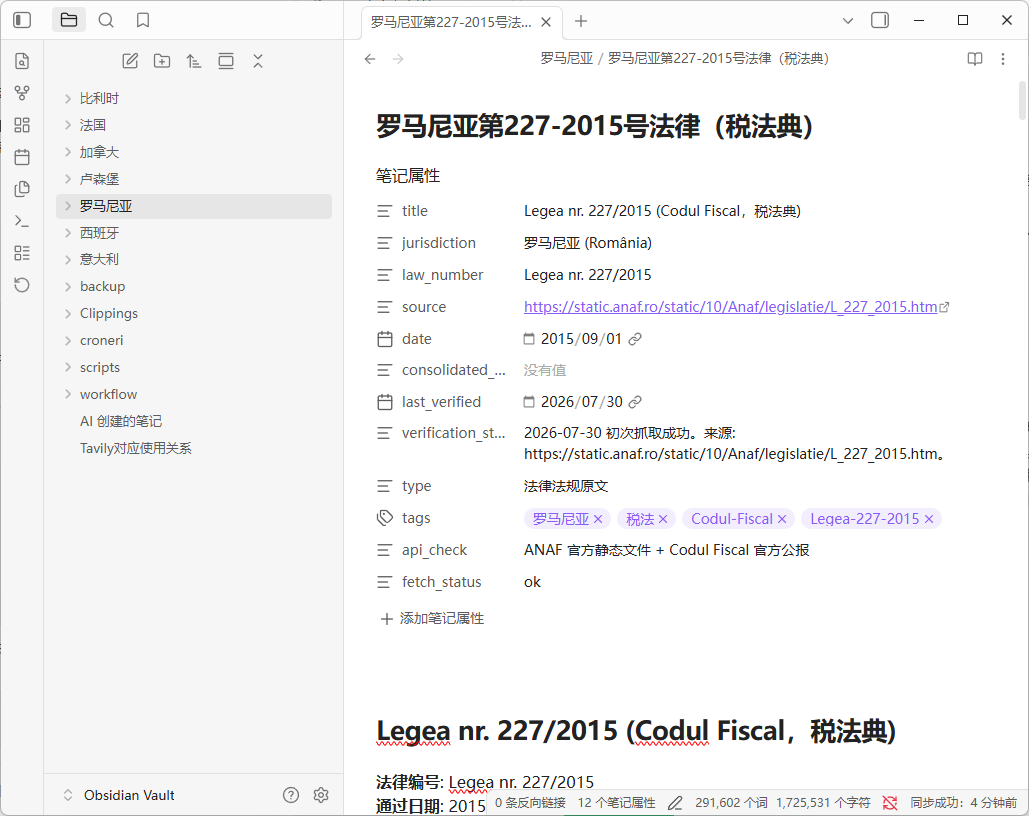
**第三层 沉淀层(Obsidian 法律库):**用 Obsidian Bases 建结构化数据表(按地区/场景/风险等级分类)、用 wikilink 关联同类场景、用 callout 高亮易踩坑点、用 Obsidian CLI 批量打标签管理属性。
三、成果展示
最终呈现:
**主交付物:**一套可复用的"检索→识别→沉淀"工作流,具体产出:。
**成果补充:**一张全球跨境合规流程图、一个 Obsidian 跨境合规知识库、一份工具组合使用规范(团队 SOP)。
**效率表现:**下次遇到同类问题,组合关键词搜索 5 秒 定位过往场景与关键结论;检索命中率与沉淀复用显著提升。
一张全球跨境合规流程图(覆盖多个司法区域),可用于内部培训。
一个 Obsidian 跨境合规知识库(按场景/地区多维检索)。
一份工具组合使用规范(什么场景用什么工具,沉淀成团队 SOP)。
四、实践经验总结
1️⃣ 别让工具单兵作战
tavily + web search 看似重复,分工用对才能把检索做到位,同时节省搜索 credits。
2️⃣ PDF 识别优先 paddle
中文 OCR 体验非常好,有免费额度,建议使用。
3️⃣ 沉淀比检索更重要
工具帮你省下的时间,如果不沉淀就白省了。
4️⃣ 规则要"前置"沉淀到 TRAE
把"PDF 用 paddle""境外用 tavily"这类偏好直接设为系统规则,AI 每次自动遵守。
五、提示词参考
💡 使用说明:触发这套工作流时用作开头指令,让 AI 按三层顺序处理跨境合规问题。
Plain
请按"检索-识别-沉淀"工作流处理这个跨境合规问题:
1. 检索层:
   - 境外法律 → 优先 tavily search/extract
   - 中国大陆法律 → 用 web search
   - 任何兜底 → mmx search
2. 识别层:
   - PDF 文件 → 优先 paddleocr 识别
   - 识别后做结构化提取
3. 沉淀层:
   - 场景结论整理成 Obsidian 格式
   - 关键结论用 callout 高亮
   - 添加 wikilink 关联同类项目
No.88|用 TraeWork 搭建企业 AI 治理平台
作者:u1501268093188411 | 数据分析 & 项目管理岗(项目经理) | 工具:TraeWork | 阅读约 5 分钟| 原帖:https://forum.trae.cn/t/topic/171927
**用法总结:**Work + Code 双模式,先定义治理指标体系,再搭数据汇聚与分析引擎,最后接入 AI Agent 实现智能决策,分 Session 迭代打磨。
**场景:**企业项目治理,从「看数据」升级到「AI 辅助决策」。
**效率提升:**原本需数小时甚至数天的经营分析,缩短到 几分钟。
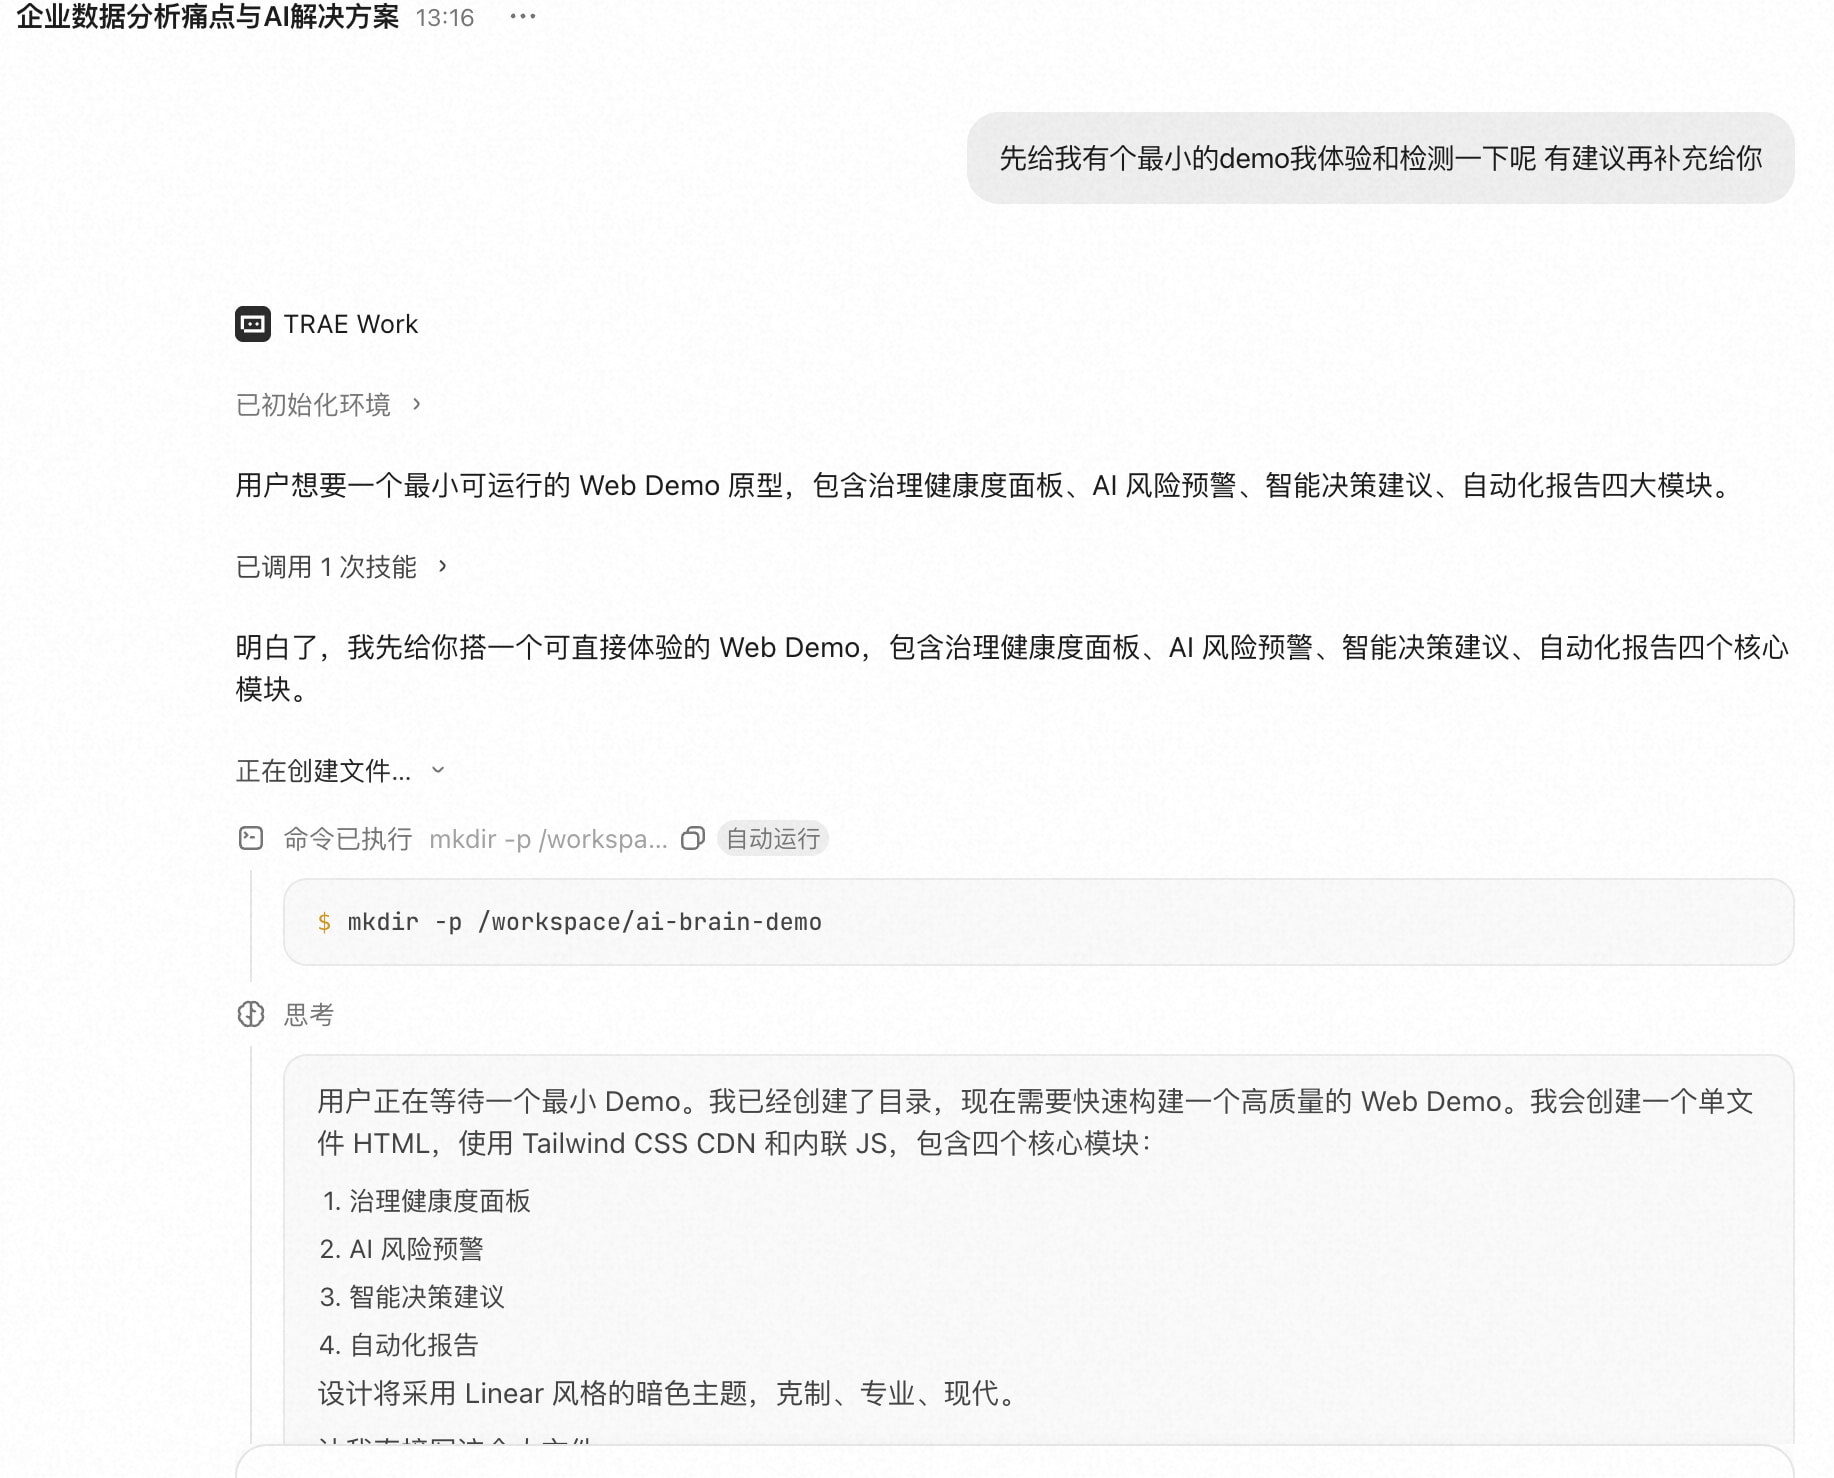
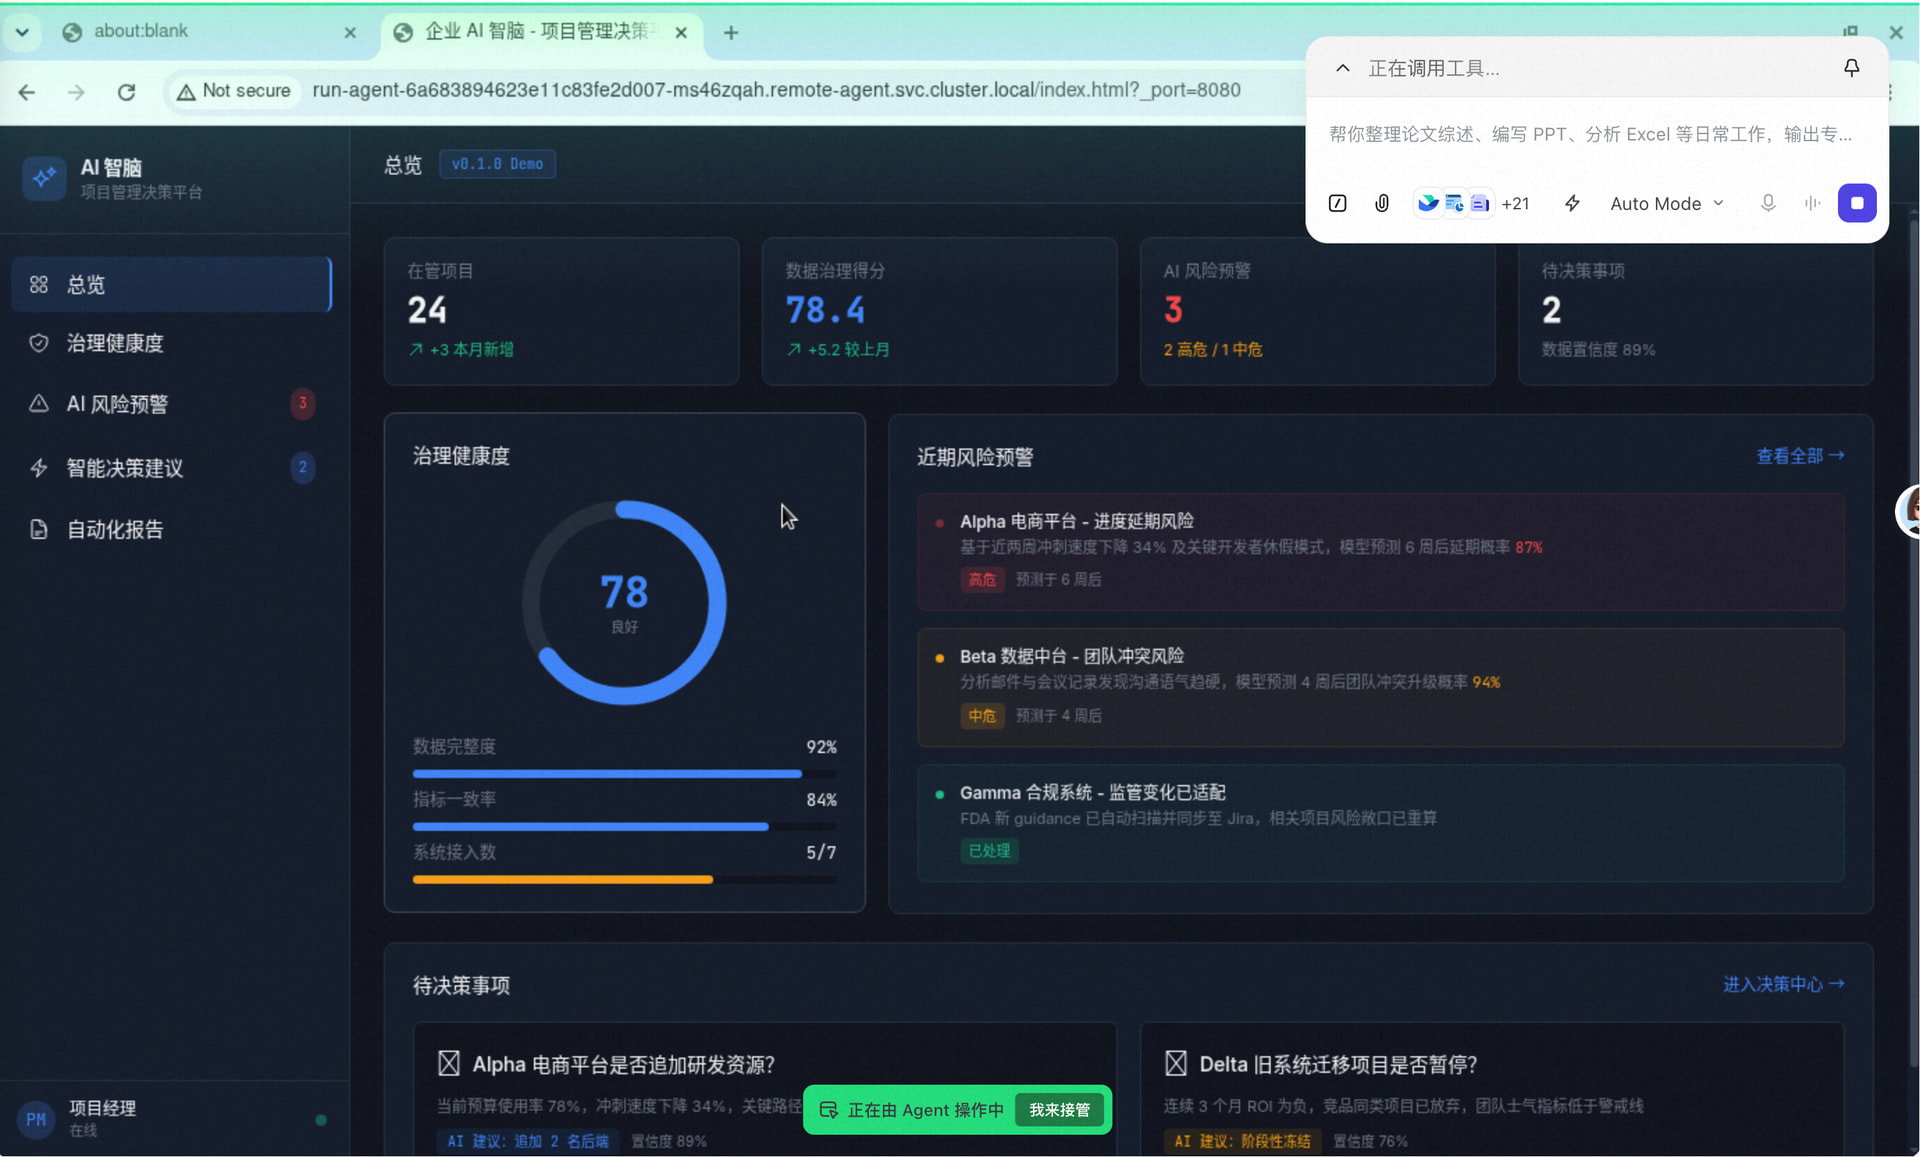
**成果:**一套 Web 企业级 AI 治理平台(Dashboard + AI Agent),含治理健康度面板、AI 风险预警、智能决策建议、自动化报告。
一、个人背景介绍
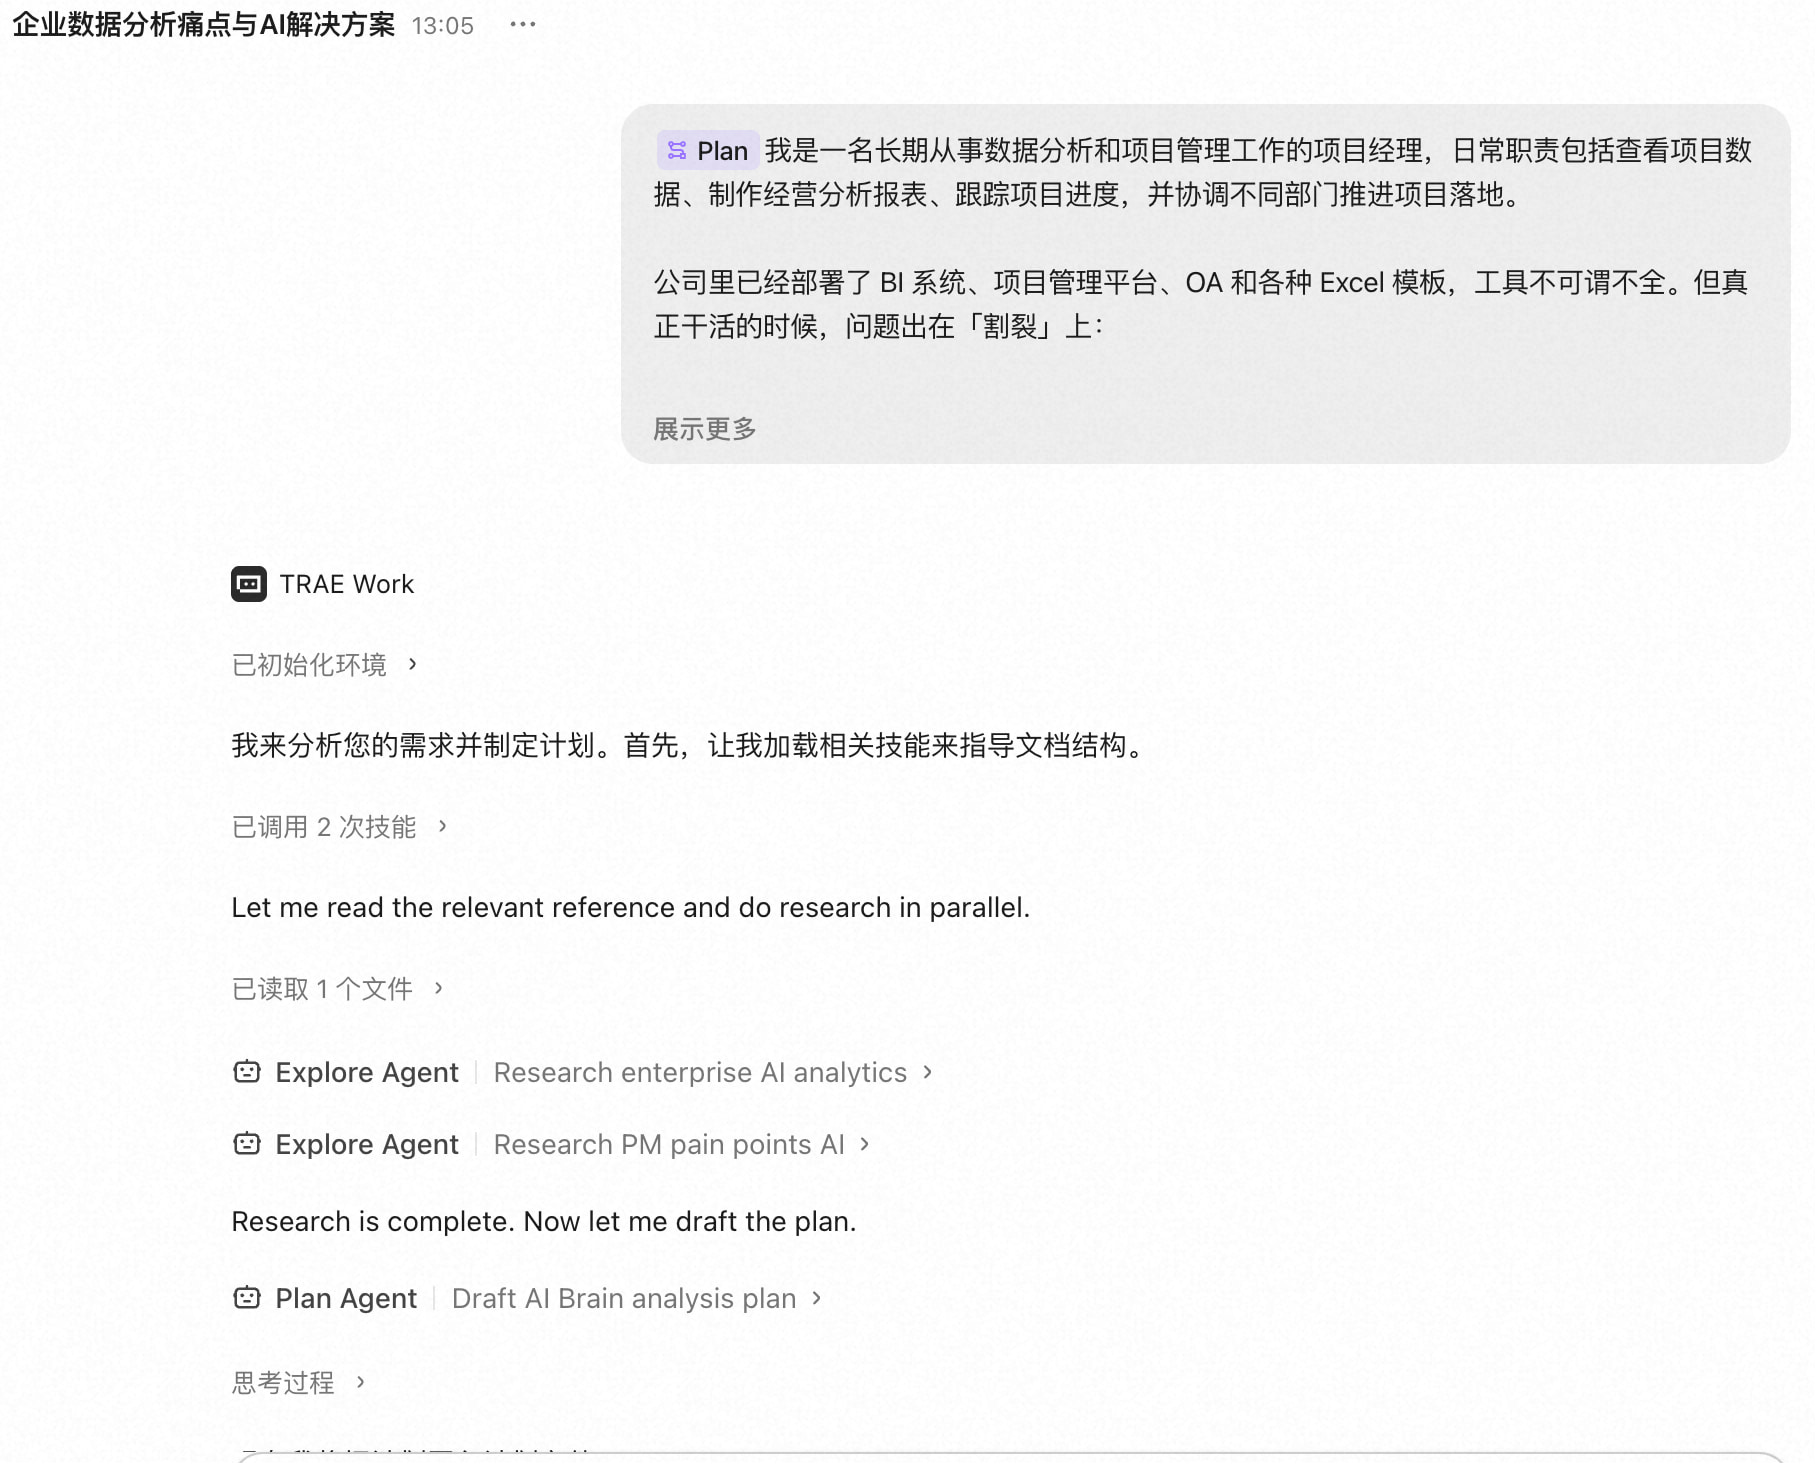
**个人背景:**作者是长期从事数据分析和项目管理的项目经理,日常要查看项目数据、制作经营分析报表、跟踪进度并协调多部门。公司虽已部署 BI、项目管理平台、OA 和各种 Excel
**当前痛点:**但问题出在「割裂」:数据分散缺统一视图、报表制作耗时、风险发现依赖人工事后处理、决策更多靠经验缺数据支撑。他意识到企业真正需要的不是更多 Dashboard,而是一颗能理解、分析、预测并辅助决策的 AI Brain。
二、我用 TraeWork 怎么解决的
**核心方案:**采用 Work + Code 模式,分四步推进:
实践步骤:
**第一步:定义治理指标体系。**梳理进度、成本、质量、资源、风险五大维度,并拆解量化指标(如里程碑达成率、预算偏差率等),先搭好骨架。
**第二步:搭建数据汇聚与治理分析引擎。**用 Code 能力持续汇聚项目数据,AI 自动完成分析并生成治理健康度评分、风险预测与优化建议。
**第三步:接入 AI Agent 实现智能决策。**系统持续分析关键指标,指标偏离阈值时主动预警并给出可执行建议(如「核查供应链报价」「调整资源分配」)。
**第四步:分 Session 迭代打磨。**从「数据展示 → 加风险预警 → 加 AI 决策建议」历经三次大迭代,长上下文让他在一个对话里讲透业务逻辑。
三、成果展示
最终呈现:
**主交付物:**最终产出一套 Web 企业级 AI 治理平台,核心模块如下:。
**成果补充:**一套 Web 企业级 AI 治理平台(Dashboard + AI Agent),含治理健康度面板、AI 风险预警、智能决策建议、自动化报告。
**效率表现:**原本需数小时甚至数天的经营分析,缩短到 几分钟。
| 模块 | 功能 | 解决的问题 |
|---|---|---|
| 治理健康度面板 | 实时展示所有项目进度、成本、质量、资源、风险五大维度健康度评分 | 替代多系统切换,统一视图一目了然 |
| AI 风险预警 | 持续监测指标偏离,自动识别风险并主动预警 | 从「事后处理」转向「事前预防」 |
| 智能决策建议 | 基于运行情况生成治理洞察、风险分析和资源优化建议 | AI 从「数据展示工具」升级为决策助手 |
| 自动化报告生成 | 一键生成含数据、图表和 AI 结论的经营分析报告 | 数小时甚至数天的分析缩短到几分钟 |
四、实践经验总结
1️⃣ 先定义指标体系,再写功能
先想清楚「治理什么、按什么维度治理」,指标体系是骨架,功能模块是血肉,骨架不对血肉白搭。
2️⃣ 分 Session 迭代,不要想一步到位
经历三次大迭代,每版跑通后才发现下一步该补什么,一次性做完反而陷入细节泥潭。
3️⃣ 让 AI 分析结论,而不只是展示数据
纯 Dashboard 价值有限,加上 AI Agent 的分析与建议后,平台价值才真正释放。
4️⃣ 业务背景要讲透
把五大维度定义、阈值逻辑和预警规则完整描述清楚,长上下文才能生成贴合实际的分析模块。
五、提示词参考
搭建治理大脑时的核心指令思路
Plain
【目标】
搭建一套企业级 AI 项目治理平台(Dashboard + AI Agent),
让 AI 从「数据展示工具」升级为企业治理的大脑。

【治理指标体系】
请帮我梳理企业项目治理的五大核心维度及量化指标:
1. 进度:里程碑达成率、延期天数、计划完成率
2. 成本:预算偏差率、实际 vs 计划比、成本趋势
3. 质量:缺陷密度、返工率、验收通过率
4. 资源:资源利用率、人员负荷、资源冲突
5. 风险:风险等级、风险数量变化、预警响应时效

【AI Agent 逻辑】
- 持续分析上述指标,生成治理健康度评分
- 指标偏离阈值时自动发出风险预警
- 基于运行情况生成治理洞察和资源优化建议
- 一键生成经营分析报告(含数据+图表+AI 结论)

【输出形态】
Web 平台,包含:治理健康度面板、AI 风险预警、智能决策建议、自动化报告
No.89|用 TraeWork 跑通政务项目全流程交付
作者:用户399 | 云服务行业 FDE(前置部署工程师) | 工具:TraeWork | 阅读约 8 分钟| 原帖:https://forum.trae.cn/t/topic/172072
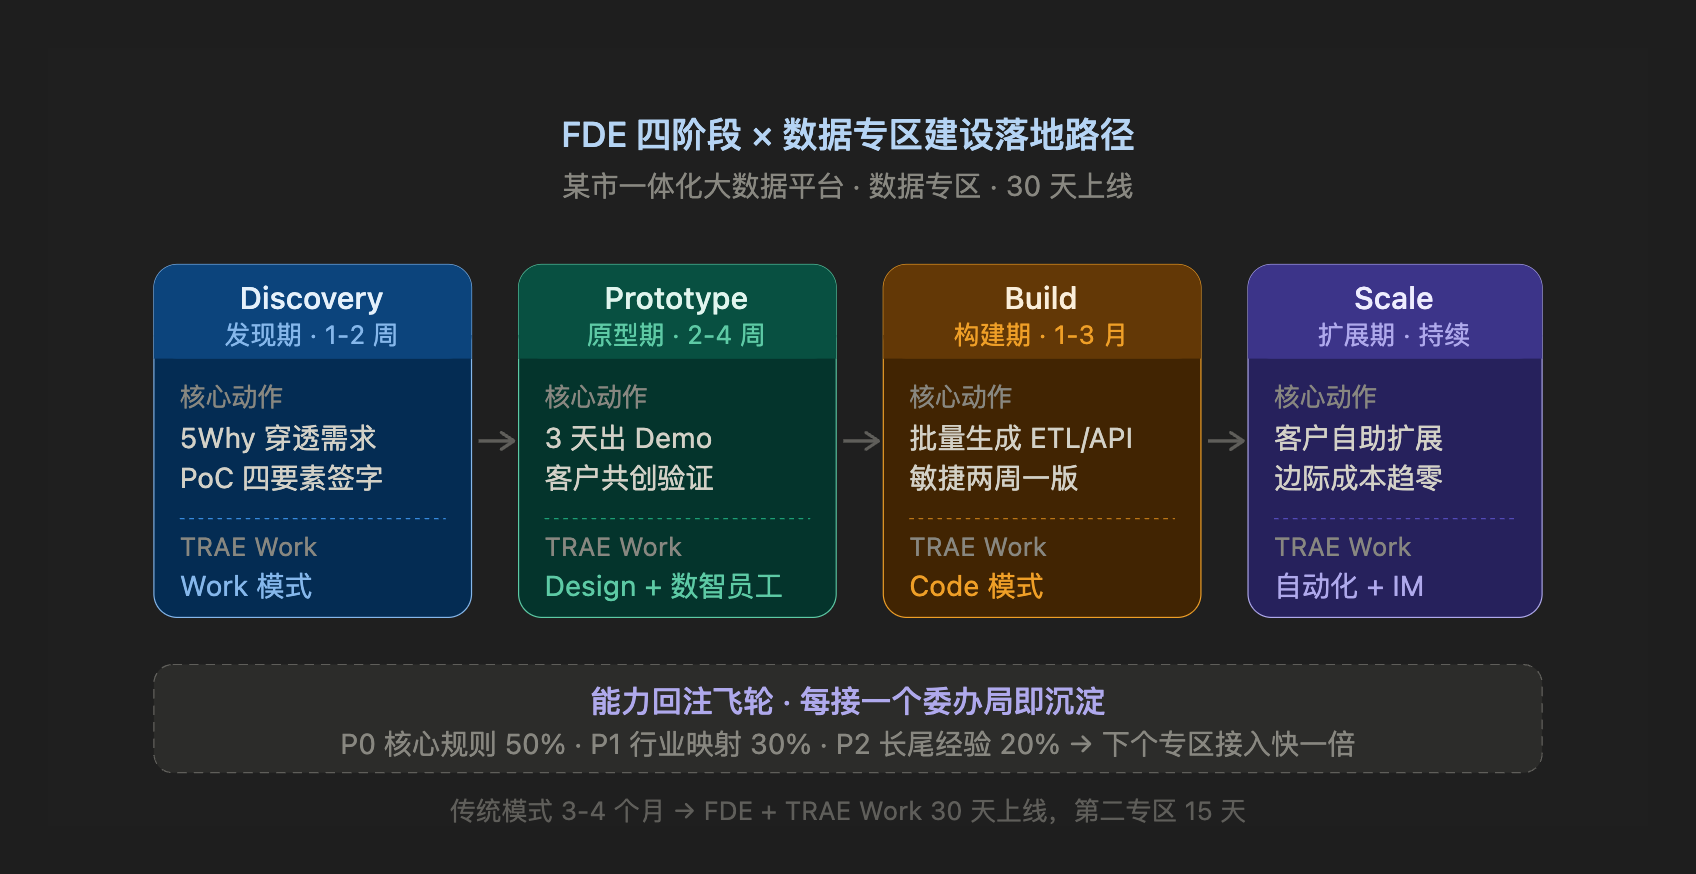
**用法总结:**用 Work/Code/Design 三模式 + 自动化任务,把 FDE 四阶段(Discovery→Prototype→Build→Scale)串成一条线,并做能力回注。
**场景:**某市政务「数据专区」建设,把 30 多个委办局数据归集、编目、治理、共享和开放。
**效率提升:**首个主题专区 30 天 跑通上线,比传统 3-4 个月压缩 60%+;第二专区仅用 15 天。
**成果:**一套覆盖「需求诊断书→架构设计图→数据治理代码包→运营监控→知识库」的 FDE 完整交付包。
一、个人背景介绍
**个人背景:**我是刚转型云服务行业的 FDE(前置部署工程师),负责某市政务数据专区建设——把全市 30 多个委办局的数据归集到一个主题专区,做编目、治理、共享和开放。遇到的
**当前痛点:**问题很典型:客户说不清要什么(80 页需求文档核心痛点被淹没,每开一次会需求就变);数据源杂、标准不一(格式从 Excel 到瀚高数据库到接口,同一字段四五种叫法);传统交付慢(瀑布 3-4 个月才出第一版,方向可能就错了);经验不沉淀(每接一个委办局都从头趟坑,换人就丢经验)。
二、提效前后对比
| 指标 | 传统瀑布模式 | FDE + TraeWork |
|---|---|---|
| 首版可见周期 | 3-4 个月 | 3 天(Demo)/ 30 天(上线) |
| 需求变更次数 | 平均 7-8 次 | 2 次(PoC 四要素锁死) |
| 第二专区接入 | 同等周期 | 15 天(复用回注资产) |
| 经验沉淀 | 靠个人记忆 | 结构化知识库,按 5:3:2 归档 |
三、我用 TraeWork 怎么解决的
**核心方案:**模式:Work + Code + Design。 把 TraeWork 当成 FDE 的「单兵作战平台」,三模式对应四阶段的不同动作。 Step 1 — Discovery(1-2 周):用 5Why 穿透「客户说的」。 把 3 份需求文档 + 5 次会议纪要 +《政务数据共享条例》交给 Work 模式按 5Why 拆解,发现真实痛点是「统一编目 + 治理规则 + 考核抓手」,再生成 PoC 四要素确认书让客户签字,堵死后续扯皮。 **Step 2 — Prototype(2-4 周):**Design + 数智员工 3 天出 Demo 拉客户共创。 用 Design 模式 10 分钟一张画出总体架构、数据归集流转、数据血缘三张图现场对改;用数智员工把民政局低保数据和人社局社保数据灌进去,3 天让客户看到自己的数据被清洗、编目、关联。 **Step 3 — Build(1-3 月):**Code 模式批量生成工程代码。 批量生成 30 个委办局 ETL 接入脚本、数据质量校验规则集、数据服务 RESTful API + 文档、数据血缘采集代码,两周一个版本敏捷迭代。 **Step 4 — Scale(持续):**从驻场到客户自助。 自动化任务每天跑质量巡检生成日报,IM 通道把日报和告警推到企微/钉钉群,培养冠军用户自己加数据源、配规则、发 API,第二专区已无需驻场。 Step 5 — 能力回注:按 5:3:2 转飞轮。 每接完一个委办局强制回注一次(P0 50% 核心治理规则/编目模板/踩坑清单,P1 30% 行业标准映射/常见质量问题解法,P2 20% 长尾场景/特殊接口经验),自动归档知识库供复用。
实践步骤:
**明确目标:**围绕“用 TraeWork 把某市政务数据专区建设跑通 FDE 四阶段交付”确定交付物、输入材料和验收标准。
**交给 TraeWork 执行:**把资料、约束和输出格式一次交代清楚,让它完成检索、整理、生成或开发等主要工作。
**人工校验与复用:**对关键数据、样式和最终交付物做检查,把可复用提示词或流程沉淀下来。
四、成果展示
最终呈现:
**主交付物:**一套覆盖「需求诊断书→架构设计图→数据治理代码包→运营监控→知识库」的 FDE 完整交付包,首个主题专区 30 天跑通上线,第二专区接入仅 15 天,边际成本持续下降(部分效果图涉密不便提供)。
**成果补充:**一套覆盖「需求诊断书→架构设计图→数据治理代码包→运营监控→知识库」的 FDE 完整交付包。
**效率表现:**首个主题专区 30 天 跑通上线,比传统 3-4 个月压缩 60%+;第二专区仅用 15 天。
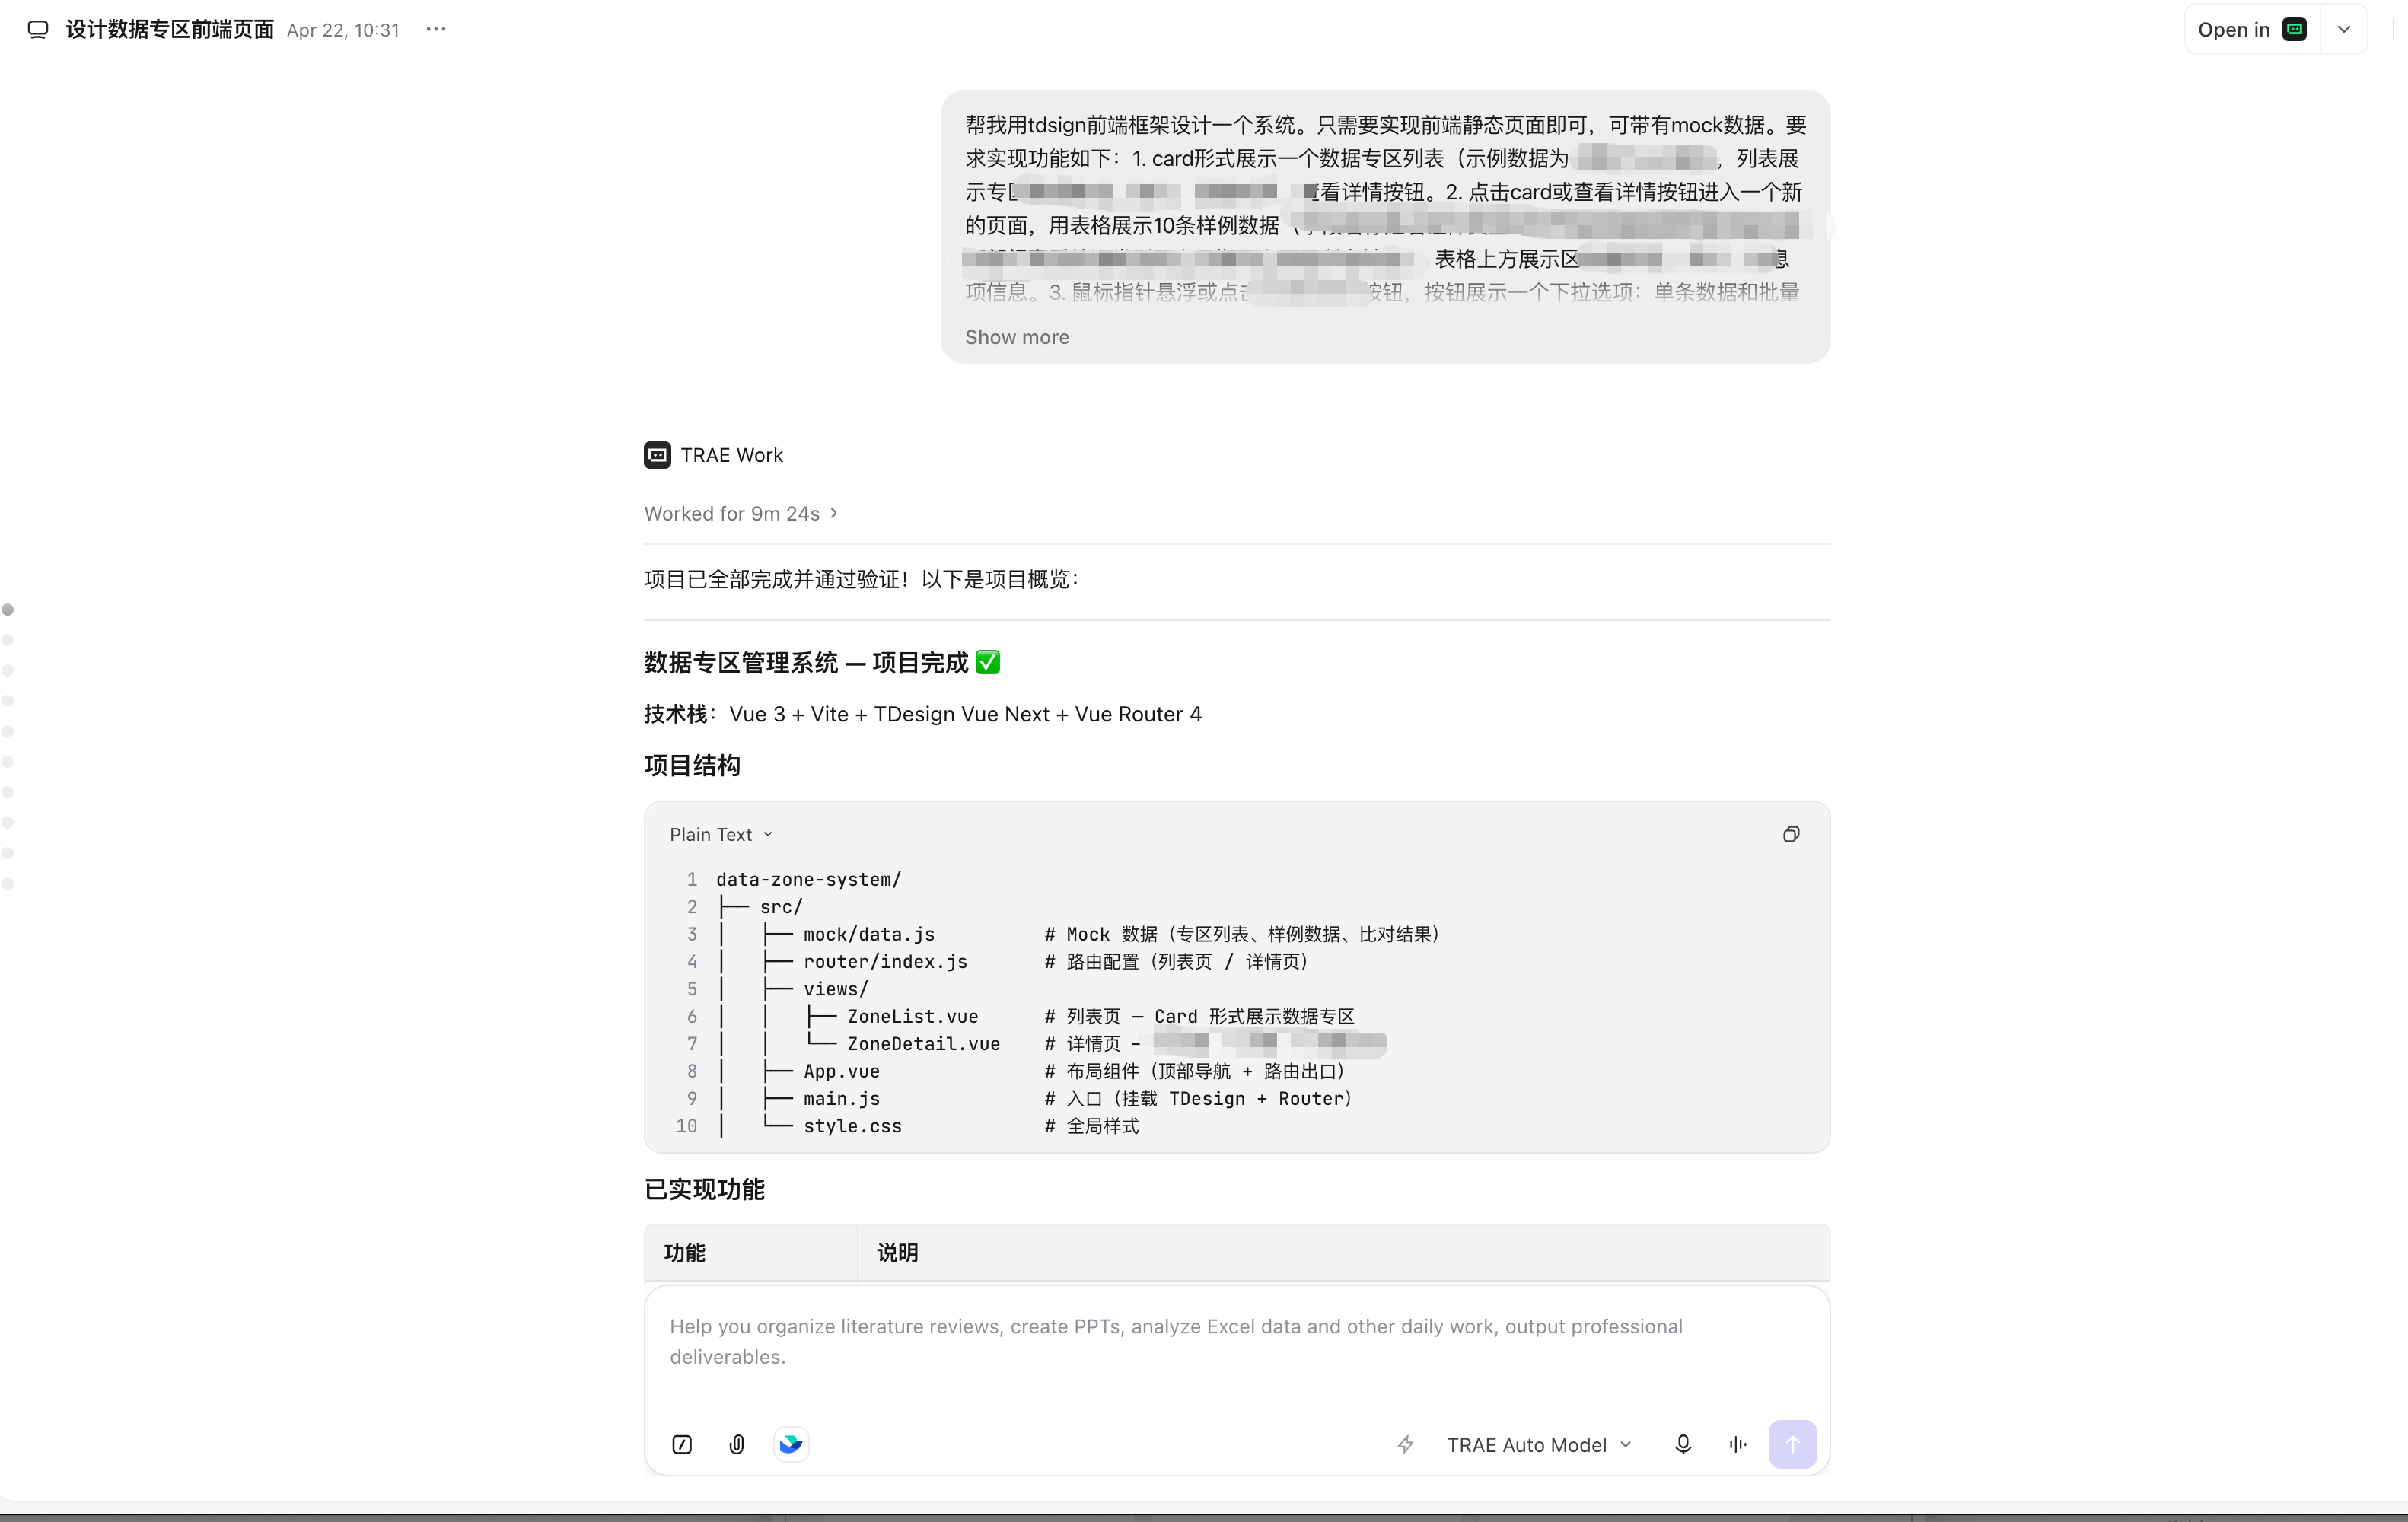
五、实践经验总结
1️⃣ Discovery 阶段别急着画架构图
先用 5Why 穿透,多半真正缺的是「统一编目 + 治理规则 + 考核抓手」,而不是平台。PoC 四要素确认书一定要让客户签字,这是堵需求变更的最强武器。
2️⃣ Prototype 一定要拉客户用真实数据共创
用数智员工 3 天出 Demo,把客户自己的数据灌进去。客户看到「我的数据能关联上」,后面 Build 阻力会小很多,别给客户看通用 Demo。
3️⃣ 能力回注别等项目结束才做
每接入一个委办局就按 5:3:2 沉淀一次并自动归档,否则人一走经验全丢。第二专区能快一倍,就是因为第一专区资产被复用。
No.90|用 TraeWork 开发助农 App
作者:u480912800481348 | 独立开发者(家乡河南周口,父母务农) | 工具:TraeWork | 阅读约 4 分钟| 原帖:https://forum.trae.cn/t/topic/171930
**用法总结:**Work 模式描述需求生成原型与前端,Code 模式接入 AI 能力并调试优化,双模式协同快速落地产品。
**场景:**面向农村中老年种植户的 AI 智慧种植管理 App「农智管家」。
**效率提升:**从想法到可运行 Demo 仅 3 天。
**成果:**完成可上线体验的 App,并入围 TRAE AI 创造力大赛初赛 Top 2000。
一、个人背景介绍
**个人背景:**作者家乡在河南周口,父母都是种了半辈子地的农民。去年父亲种的两亩番茄因未及时发现早疫病几乎绝收,这让他意识到
**当前痛点:**传统经验种地已跟不上气候与病虫害的变化,而农村老龄化让「谁来种地」成为严峻问题。作为有想法但时间有限的开发者,他想做一个真正帮到农村父母的 AI 工具,并需要在短时间内做出可参赛的 Demo。
二、我用 TraeWork 怎么解决的
**核心方案:**整个开发按「3 天从 0 到 Demo」推进:
实践步骤:
**Day 1(Work 模式搭原型):**用自然语言描述「面向农村父母、大字简洁、含天气/土壤湿度/AI 病虫害识别/智能灌溉建议」的需求,TraeWork 直接生成完整前端页面,截图给父母看一眼就懂。
**Day 2(Code 模式接入 AI 能力):**接入百度 AI 图像识别做病虫害识别,结合和风天气 API 与土壤湿度做智能灌溉决策,内置作物种植知识库;遇报错直接丢给它定位。
**Day 3(打磨体验准备交付):**放大字体与按钮、用方言化语言替换专业术语、加语音播报,并部署到 Railway 生成在线体验链接。
三、成果展示
最终呈现:
**主交付物:**最终交付一套完整作品「农智管家——AI 赋能农村父母智慧种植系统」,核心信息如下:。
**成果补充:**完成可上线体验的 App,并入围 TRAE AI 创造力大赛初赛 Top 2000。
**效率表现:**从想法到可运行 Demo 仅 3 天。
| 项目 | 内容 |
|---|---|
| 作品名称 | 农智管家——AI 赋能农村父母智慧种植系统 |
| 核心功能 | AI 病虫害识别、智能灌溉建议、种植知识库、市场行情 |
| 技术栈 | HTML5 + JavaScript + 百度 AI / 和风天气 / 通义千问 API |
| 开发周期 | 3 天 |
| 大赛成绩 | 入围 TRAE AI 创造力大赛初赛 Top 2000 |
作者把链接发给父亲,他每天起床第一件事就是打开「农智管家」看灌溉建议,遇到不认识的虫子拍照识别。父亲评价:「这比问你二舅管用多了。」
四、实践经验总结
1️⃣ Work 出原型、Code 做深度
Work 模式降低做原型门槛,Code 模式保证深入调试与优化,双模式配合让想法快速跑起来。
2️⃣ 面向真实用户做适老化
大字体、大按钮、方言化术语、语音播报,让不识字的老人也能用起来。
3️⃣ 报错直接丢给 AI 定位
接 API 遇到问题时把报错交给 AI,基本都能快速定位并给出修复。
五、提示词参考
Day 1 搭原型时的核心需求描述
Plain
帮我做一个面向农村父母的种植助手 App,首页要有天气、土壤湿度、AI 病虫害识别入口、智能灌溉建议,整体风格要简洁大字,适合老年人使用。Day 2 Code 模式接入 AI 能力
Plain
AI 病虫害识别:接入百度 AI 图像识别 API,拍照即可识别病虫害并给出防治方案
智能灌溉决策:结合和风天气 API 和土壤湿度数据,自动推荐灌溉时间和水量
种植知识库:内置小麦、玉米、番茄等作物的科学种植指南
Day 3 打磨体验,准备交付
Plain
把字体调大、按钮调大,适配老年人视力
用方言化的语言替换专业术语(比如把"墒情"改成"土壤湿度够不够")
添加语音播报功能,让不识字的父母也能用
部署到 Railway,生成在线体验链接
No.91|用 TraeWork 生成软著申请材料
作者:u3833375825083225 | 医院信息科开发者 | 工具:TraeWork | 阅读约 4 分钟 | 原帖:https://forum.trae.cn/t/topic/172335
**用法总结:**用 TraeWork 的代码阅读理解 + 文档生成 + 命令执行三大能力,全程在对话窗口内生成软著申请书、源代码 PDF 全套材料。
**场景:**独立开发的 3 万行「医院等级评审数据管理系统」要申请软件著作权,面对十几个申请字段和源代码整理无从下手。
**效率提升:**全套材料约 30 分钟完成,省去翻代码、查配置、排版至少一整天。
**成果:**9 页申请文件 PDF + 62 页源代码 PDF + HTML 版申请书。
一、个人背景介绍
**个人背景:**作者是医院信息科开发者,独立开发了一套「医院等级评审数据管理系统」,代码量约 3 万行。系统开发完成后需申请软件著作权
**当前痛点:**但面对申请表十几个字段(开发环境、运行环境、技术特点、功能描述等)以及源代码文档整理,完全不知从何下手。
二、我用 TraeWork 怎么解决的
**核心方案:**模式:Work。用代码阅读理解 + 文档生成 + 命令执行三大能力,全程没离开对话窗口:
第一步:让 AI 读代码搞清系统是什么。把整个项目文件夹交给它,它自己扫 app.py(4905 行)、README、requirements.txt、前端模板目录等,自动总结技术栈、功能模块、架构设计,连 882 个指标、55 个单病种这些细节都从代码里读出来。
第二步:逐项填写软著申请表字段。开发硬件环境、运行环境、操作系统、开发工具、面向行业、开发目的、主要功能、技术特点等逐个提问,它结合代码实际回答;填开发硬件环境时直接跑 PowerShell 命令检测机器 CPU/内存/硬盘型号,精确到「AMD Ryzen 9 270H / 32GB / ASUS Adolbook 14」。
第三步:自动提取源代码 + 生成 PDF。写 Python 脚本自动合并 10 个源文件、按规范截取 3000 行,生成带文件清单和分页标注的源代码文档,再用 Edge 无头模式把 HTML 申请书转成 PDF,源代码也转成 62 页 PDF。
实践步骤:
**明确目标:**围绕“用 TraeWork 一键生成软著申请全套材料(申请书+源代码PDF)”确定交付物、输入材料和验收标准。
**交给 TraeWork 执行:**把资料、约束和输出格式一次交代清楚,让它完成检索、整理、生成或开发等主要工作。
**人工校验与复用:**对关键数据、样式和最终交付物做检查,把可复用提示词或流程沉淀下来。
三、我做出了什么
最终呈现:
**主交付物:**一份完整的软著申请材料包:9 页申请文件 PDF(含封面、申请表、功能模块、技术特点、运行环境等)+ 62 页源代码 PDF(前 30 页+后 30 页,每页 50 行带页码)+ HTML 版申请书。全程约 30 分钟,省去至少一整天的翻代码、查配置、排版工作。
**成果补充:**9 页申请文件 PDF + 62 页源代码 PDF + HTML 版申请书。
**效率表现:**全套材料约 30 分钟完成,省去翻代码、查配置、排版至少一整天。
四、实践经验总结
1️⃣ 先让 AI 读代码再填表
「主要功能」「技术特点」等字段与其自己手写,不如让 AI 扫一遍代码后基于实际实现来描述,比人脑总结更全面准确。
2️⃣ 硬件环境直接跑命令检测
开发机和运行环境的硬件配置不用手动查,让 AI 跑条系统命令就能拿到真实参数,填表更靠谱。
3️⃣ 源代码提取用脚本最稳
手动复制 3000 行代码易出错,写脚本自动合并、截取、分页并加文件清单和页码,一步到位。
五、提示词参考
💡 使用说明:分步触发申请书生成、源代码导出、格式转换,字段逐项提问由 AI 结合代码回答。
Plain
帮我写这个系统的软著申请书
(AI 自动扫描项目代码,生成申请文件 HTML)

帮我把源代码导出为PDF
(AI 写脚本提取前30页+后30页代码,转成62页PDF)

帮我把申请文件转换成PDF
(AI 用 Edge 无头模式把 HTML 转为 9 页 PDF)

开发的硬件环境 / 运行的硬件环境 / 软件开发环境 / 运行支撑环境 / 开发目的 / 面向领域 / 主要功能 / 技术特点
(逐项提问,AI 结合代码实际逐一回答)
No.92|用 TraeWork 做 AI 供应链助理,每周省下 1 个工作日
作者:Azure | 制造型企业供应链采购 | 工具:TraeWork | 阅读约 3 分钟 | 原帖:https://forum.trae.cn/t/topic/172565
**用法总结:**把 AI 引入供应链采购工作流,让合同、审批、Excel、归档等重复劳动自动化处理。
**场景:**制造型企业供应链采购,每天与合同、审批、Excel 和归档打交道,重复劳动繁重(含"手动录 30 列"的表格作业)。
**效率提升:**重复劳动从每天 9.5 小时 压缩到 1.6 小时,相当于每周省下 1 个工作日。
**成果:**一套完整的 AI 供应链助理打法与省钱心法(附作者分享的 AI供应链助理.html)。
一、个人背景介绍
身份:在制造型企业做供应链采购。
痛点:每天和合同、审批、Excel、归档打交道,重复性手工作业繁多,典型如手动录入 30 列的表格。
二、提效前后对比
| 指标 | 引入 AI 前 | 引入 AI 后 |
|---|---|---|
| 每日重复劳动耗时 | 9.5 小时 | 1.6 小时 |
| 表格录入 | 手动录 30 列 | AI 自动处理 |
| 每周结余 | — | 约 1 个工作日 |
三、我用 TraeWork 怎么解决的
把合同、审批、Excel、归档等日常采购环节接入 AI 工作流,用 AI 完成信息提取与整理。
将原先需要手动录入的大量表格列交给 AI 自动填充,大幅压缩重复劳动时间。
沉淀出一套可复用的打法与"省钱心法",兼顾提效与成本控制。
四、成果展示
最终呈现:
**主交付物:**作者将完整实践打法整理成一份可交互的 HTML 文档「AI供应链助理.html」在论坛分享,系统性说明了从手动录入到自动化的完整转型路径与省钱心法。总体效果:把 9.5 小时的重复劳动压缩到 1.6 小时。
**成果补充:**一套完整的 AI 供应链助理打法与省钱心法(附作者分享的 AI供应链助理.html)。
**效率表现:**重复劳动从每天 9.5 小时 压缩到 1.6 小时,相当于每周省下 1 个工作日。
五、实践经验总结
1️⃣ 聚焦高频重复环节
优先把"每天都要做、又高度重复"的合同、表格、归档类工作交给 AI,提效收益最大。
2️⃣ 兼顾提效与成本
作者强调在提效的同时关注"省钱心法",让 AI 的投入产出比更优。
No.93|用 TraeWork 搭建工厂生产质量看板
作者:Jayce | 制造企业一线工程师 | 工具:TraeWork | 阅读约 6 分钟 | 原帖:https://forum.trae.cn/t/topic/173120
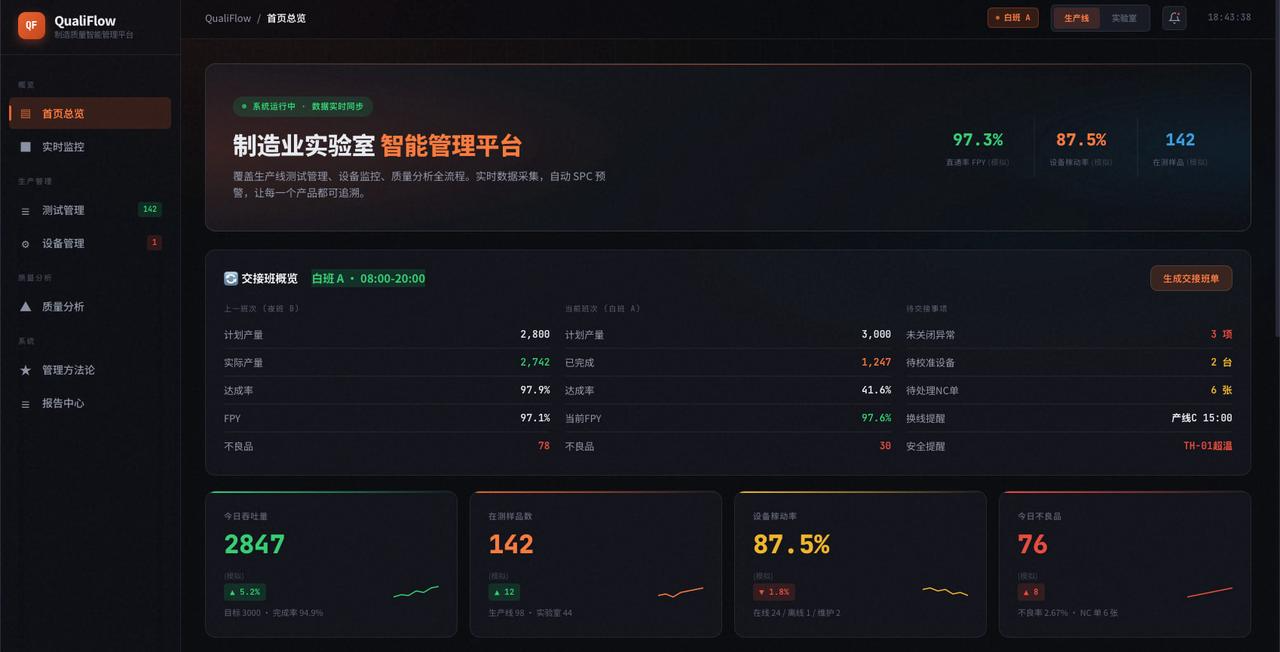
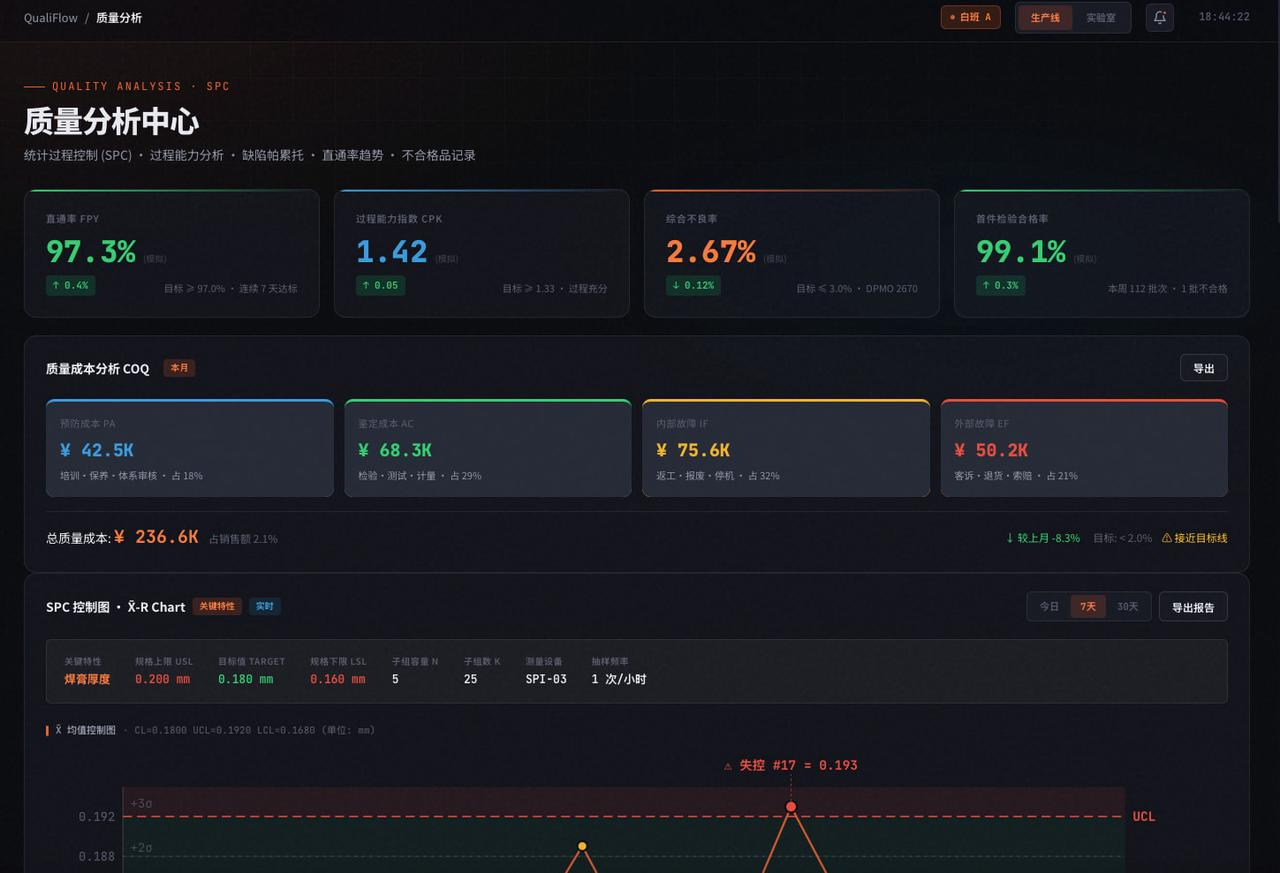
**用法总结:**一个从没写过代码的一线工程师,把车间痛点一句句讲给 TraeWork,做出面向制造业的全流程质量智能管理系统 QualiFlow(前端交互原型)。
**场景:**制造业生产质量管理 / 车间数字化
**效率提升:**异常响应从 15–20 分钟压到 10 分钟以内,交接班信息零遗漏
**成果:**含安灯升级系统、质量数据驾驶舱、班次全链路管理三大模块的深色风格质量看板
一、个人背景介绍
**身份:**制造企业一线工程师,从没真正写过代码。
痛点:
**异常响应黑洞:**设备停了要跑去找班长再打电话给工程师,一次异常响应平均 15–20 分钟,损失以万计。
**班次信息断层:**白班发现和调整的问题夜班完全不知道,同样异常反复出现。
**质量成本不可见:**预防/鉴定/内外故障成本说不清,改善投入像黑暗中射箭。
**停机原因一本糊涂账:**月底复盘各说各话,缺数据支撑。
二、我用 TraeWork 怎么解决的
**核心方案:**整个过程说起来很简单:把脑子里的想法一句句讲给它听,像跟同事描述需求一样。
实践步骤:
"我要一个深色风格的制造质量看板,左边导航栏,右边数据卡片,顶部要有实时时钟和班次标识"——它就画出来了。
"安灯按钮点下去要有倒计时,5 分钟超时自动变红"——它就写出完整倒计时逻辑。
三、成果展示
最终呈现:
**主交付物:**含安灯升级系统、质量数据驾驶舱、班次全链路管理三大模块的深色风格质量看板。
**效率表现:**异常响应从 15–20 分钟压到 10 分钟以内,交接班信息零遗漏。
**① 安灯升级系统:**一键触发异常上报,自动通知班组长和产线工程师,5 分钟响应倒计时,超时自动标红升级。
**② 质量数据驾驶舱:**COQ 四类成本分析、SPC X̄-R 控制图、Cpk 过程能力分析、停机 Pareto 分析。
**③ 班次全链路管理:**自动识别白班 A / 夜班 B,交接班面板零信息遗漏,5 维度班次绩效对比。
四、实践经验总结
1️⃣ 不懂代码,就用"跟同事描述需求"的方式说清楚
把界面和交互一句句讲给 TRAE,它把口语需求翻译成可运行的界面与逻辑。
2️⃣ 从最痛的场景切入,价值最直观
先做异常响应的安灯升级,把 35 分钟的响应黑洞压到 10 分钟内,收益一眼可见。
3️⃣ 车间系统要给现场人用,别照搬 IT 后台
操作员查 SOP 不该点 5–6 层菜单,界面围绕现场角色的真实动线来设计。
No.94|用 TraeWork 开发餐饮点单小程序
作者:自由职业全栈开发 | 小程序 / H5 开发 | 工具:TraeWork | 阅读约 4 分钟 | 原帖:https://forum.trae.cn/t/topic/173340
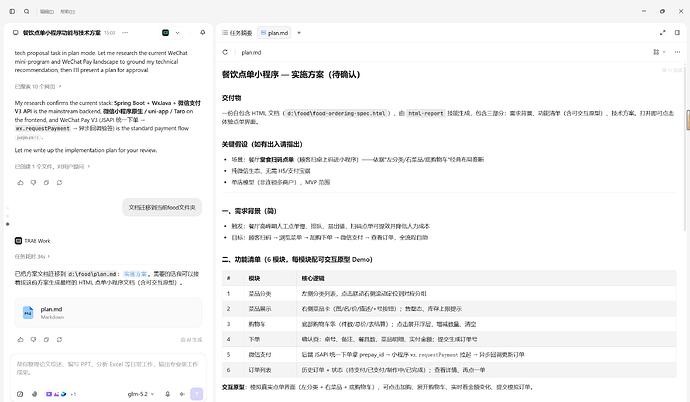
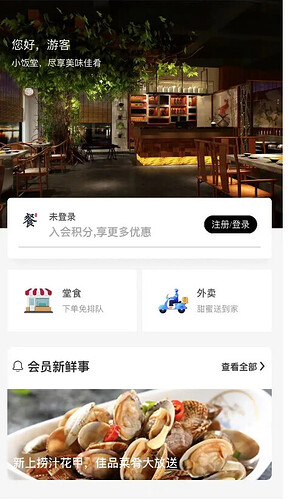
**用法总结:**用 TRAE 的讨论模式 + Plan 模式 + 代码生成 + 手机端同步,从语音需求到逐页生成 WXML/WXSS/JS,再到交付文档,三天做完一个餐饮点单小程序。
**场景:**接单外包 / 微信小程序开发
**效率提升:**以前这种项目至少一周 —— 这次 3 天 交付,客户一次验收通过,尾款当天到账
**成果:**6 个页面 + 微信支付 + 会员积分的完整点单小程序 + 交付文档与部署说明
一、个人背景介绍
**身份:**自由职业全栈开发,主要接中小企业的小程序和 H5 项目。
**痛点:**客户要一个餐饮点单小程序(左分类右菜品、底部购物车、微信支付),排期只有三天,以前至少要一周。
二、我用 TraeWork 怎么解决的
**Step 1 讨论模式:**把客户语音转文字需求丢进去,TRAE 梳理出功能清单(分类、购物车、下单、支付、订单列表)并建议技术方案。
**Step 2 Plan 模式:**按页面拆解任务,逐页生成 WXML + WXSS + JS。
**Step 3 预览调样式:**在开发者工具里预览,把截图丢回给 TRAE 调细节。
**Step 4 手机端改需求:**客户中途加"会员积分",直接在手机上用 TRAE 改,回电脑代码已同步。
**Step 5 生成交付物:**让 TRAE 根据代码和 commit 生成交付文档与部署说明,打包发客户。
三、成果展示
最终呈现:
**主交付物:**6 个页面 + 微信支付 + 会员积分的完整点单小程序 + 交付文档与部署说明。
**效率表现:**以前这种项目至少一周 —— 这次 3 天 交付,客户一次验收通过,尾款当天到账。
四、实践经验总结
1️⃣ 客户改需求是常态,把变更点直接描述给 TRAE
它基于已有代码改,不会打乱整体结构,验收阶段加需求也不慌。
2️⃣ 手机端能救急
在地铁上就能描述"购物车数量不对",到站时修复方案已经出来,回电脑代码已同步。
3️⃣ 交付文档让 TRAE 生成
根据代码和 commit 记录生成交付文档与部署说明,又规范又快,不用自己写。
五、提示词分享
Plain
我要做一个微信小程序,功能是餐饮门店点单。
页面结构:左侧菜品分类导航,右侧菜品列表,底部固定购物车栏。
技术栈:原生微信小程序,不用框架。
请先生成点单主页面的 WXML + WXSS + JS,
菜品数据先用本地 mock 数组,包含:菜品名、价格、图片、分类。
交互要求:点击分类切换右侧列表,点击"+"加入购物车,底部实时显示总价。
No.95|用 TraeWork 整理防汛物资库存数据
作者:小博同学 | 基层季节性物资统筹 | 工具:TraeWork | 阅读约 5 分钟 | 原帖:https://forum.trae.cn/t/topic/173096
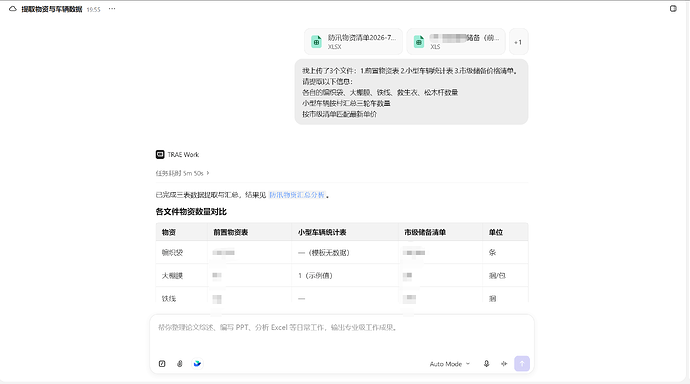
**用法总结:**把 TraeWork 当"物资库存智能中台",不建数据库、不写代码,靠对话完成数据录入、价格核算、模板适配和上报文本生成。
**场景:**基层政务 / 防汛物资填报
**效率提升:**手工处理 30 分钟 —— 降到 几分钟 完成,价格 零误差,改需求只需一句话
**成果:**一份自动填充的统计表(百行数据、多类物资、全辖区落实)+ 可直接复制发群的上报文本
一、个人背景介绍
**身份:**在基层负责季节性物资统筹,汛期要汇总防汛物资储备。
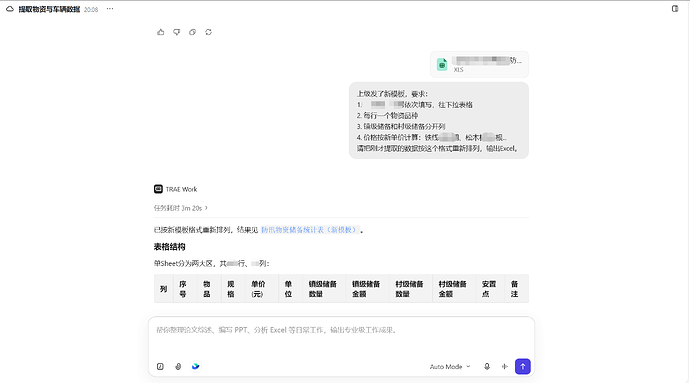
**痛点:**同一批数据要填进 3 种格式的 Excel 模板,手工复制粘贴极易出错;物资价格随批次变化每次都要重新核对;上级临时调整要求(如"某物资按村均分 8 件")整个表格要推倒重来,一个报表改十几版是常态。
二、我用 TraeWork 怎么解决的
**模式:**Work(文档/表格处理)+ 检索文件(核对历史采购价格)
**数据录入:**把零散数据(Excel、截图、微信文字)直接丢给它,自动识别并结构化。
**价格核算:**让它检索历史采购清单,自动匹配最新单价(如大棚膜 1260 元/捆、铁线 288 元/捆),算分项总价。
**模板适配:**把新模板和规则发给它,自动把数据翻译成新格式(一行一物资、本级下级拆分、自动填存放地点)。
**上报生成:**按固定话术自动生成"XX市上报,编织袋XXXX条,xx镇XX村XXXX条…",直接复制发群。
三、成果展示
最终呈现:
**主交付物:**一份自动填充的统计表(百行数据、多类物资、全辖区落实)+ 可直接复制发群的上报文本。
**效率表现:**手工处理 30 分钟 —— 降到 几分钟 完成,价格 零误差,改需求只需一句话。
四、实践经验总结
1️⃣ 让 AI 当"数据路由器",别让它记数据
把原始文件上传让它实时读取、实时计算,避免让它记全部数据产生幻觉。
2️⃣ 价格单独建"知识库"
把带单价的历史采购清单存成 Excel,每次先上传让它按此计价,避免重新询价。
3️⃣ 模板变化用"格式截图",上报文本一键生成
发新模板直接截图表头,比文字描述"第 3 列合并"准确 100 倍;最后让它按固定话术输出直接发群。
五、提示词分享
Plain
【数据录入阶段】
我上传了3个文件:1.各村前置物资表 2.小型车辆统计表 3.市级储备价格清单。
请提取以下信息:各自的编织袋、大棚膜、铁线、救生衣、松木杆数量;小型车辆汇总数量;按市级清单匹配最新单价。

【模板适配阶段】
上级发了新模板,要求:1.一个村一个村依次填写,往下拉表格;2.每行一个物资品种;3.本级储备和下级储备分开列;4.价格按新单价计算。
请把刚才提取的数据按这个格式重新排列,输出Excel。

【上报生成阶段】
按市里要求,生成上报文本:"XXX上报,编织袋条,本级XXX条、XX镇XXX条...",五类物资分别生成一段。
No.96|用 TraeWork 做法律自媒体内容创作
作者:法律从业者 / 法律内容运营 | 工具:TraeWork(Work + 联网检索 + 文档写作)| 阅读约 5 分钟
**用法总结:**用 TraeWork 把“选题搜索、法规检索、案例拆解、口语化改写、平台内容适配”串成一条法律自媒体内容生产流程,让严肃法律知识变成用户看得懂、愿意收藏、还能降低合规风险的图文或短视频脚本。
**场景:**法律咨询、律师事务所、企业法务或法律博主,需要围绕劳动争议、婚姻家事、合同纠纷、跨境合规、消费者权益等主题持续产出内容,但既要专业准确,又不能写得太像法条说明书。
**效率提升:**从人工找选题、查法规、写初稿、反复改口语表达的 2-3 小时,压缩到 20-30 分钟完成一篇可发布初稿。
**成果:**一套法律自媒体内容创作工作流,包含热点选题池、法规与案例依据、图文笔记、短视频脚本、标题备选和发布前合规自查清单。
一、个人背景介绍
我是法律行业从业者,平时需要持续做法律科普内容。一方面,用户真正关心的是“我遇到这种情况怎么办”,比如公司突然调岗能不能拒绝、租房押金不退怎么办、合同里哪些条款有坑;另一方面,法律内容又不能随便写,必须有依据,不能夸大承诺,也不能把个案结论说成普遍结果。
以前做一篇内容,要先刷平台找热点,再查法条和案例,然后把专业表达改成普通人能听懂的话。最麻烦的是,写得太专业没人看,写得太口语又怕不严谨。
二、提效前后对比
三、我用 TraeWork 怎么解决的
核心方案是让 TraeWork 先做“法律研究助理”,再做“内容编辑”。先查清楚事实、法规和边界,再进入内容创作,避免一上来就写成情绪化爆款文。
具体流程分五步:
**建立选题池:**每天让 TraeWork 搜集平台上的法律相关热点问题,比如劳动仲裁、房屋租赁、消费维权、婚姻家事、合同纠纷等,并整理成“用户问题 - 争议点 - 适合平台 - 内容角度”的表格。
**查找法律依据:**对每个选题,要求 TraeWork 检索对应法律条文、司法解释、官方问答或典型案例,并标注来源。没有明确依据的内容,统一标为“需人工复核”,不直接进入发布稿。
**拆成用户能懂的问题:**把专业问题改写成用户视角,例如“公司不发年终奖违法吗?”“试用期被辞退能要赔偿吗?”“合同没盖章还有效吗?”每个问题都拆成场景、关键判断点、可能结果和行动建议。
**生成平台内容:**根据发布平台生成不同版本:小红书图文偏“问题 + 结论 + 避坑清单”,抖音短视频偏“开头冲突 + 案例讲解 + 行动建议”,公众号偏“完整逻辑 + 法条依据 + 操作步骤”。
**发布前合规自查:**最后让 TraeWork 检查是否存在绝对化承诺、夸大结果、诱导诉讼、缺少前提条件、把个案当通用结论等风险,并给出修改建议。
四、成果展示
最终产出一套可复用的法律自媒体内容包:
今日法律热点选题表
每个选题对应的法规和案例依据
小红书图文版内容
抖音短视频口播脚本
公众号长文大纲
标题备选 10 条
发布前合规自查清单
例如一个“公司单方面调岗能不能拒绝”的选题,可以产出:
小红书标题:公司突然调岗,我一定要服从吗?
短视频开头:老板一句话让你去外地上班,不去就算旷工,这合法吗?
正文结构:先说结论,再解释“劳动合同约定、岗位变化幅度、薪资是否降低、是否具有惩罚性”四个判断点。
行动建议:保留通知记录、工资变化记录、沟通截图,必要时咨询当地劳动监察或律师。
五、实践经验总结
法律内容必须先查依据,再写爆款 不能一上来就让 AI 写“吸引人的标题”。法律内容的底线是准确,先查法条、案例和适用条件,再做表达优化。
不要把个案结论写成普遍结论 同一个劳动争议,不同城市、不同合同约定、不同证据情况,结果可能完全不同。要让 TraeWork 明确写出“适用前提”和“例外情况”。
平台表达可以口语化,但判断不能模糊 标题可以贴近用户,但正文里的判断逻辑必须清楚。比如“公司调岗不一定违法”,要说明看合同约定、合理性、薪资变化和协商过程。
每篇内容都要有合规自查 尤其避免“包赢”“一定赔”“百分百违法”这类绝对化表达。法律自媒体不是制造焦虑,而是帮用户理解风险和下一步行动。
六、提示词参考
Plain
你是法律自媒体内容策划助手。请围绕我给出的法律话题,生成一份可发布的内容方案。

任务目标:
1. 先判断这个话题适合哪些平台发布:小红书、抖音、公众号、视频号;
2. 检索并整理相关法律依据,包括法律条文、司法解释、官方说明或典型案例;
3. 把专业法律问题改写成普通用户能理解的问题;
4. 生成小红书图文版、短视频口播版和公众号长文大纲;
5. 最后做发布前合规检查。

输入话题:
【在这里填写法律选题,例如:公司单方面调岗,员工能不能拒绝】

输出格式:
一、选题判断
- 用户痛点
- 争议点
- 适合平台
- 内容角度

二、法律依据
- 相关条文
- 典型案例或官方解释
- 适用前提
- 不确定或需人工复核的信息

三、小红书图文版
- 标题 5 个
- 开头
- 正文结构
- 避坑清单
- 结尾互动问题

四、短视频口播版
- 3 秒开头钩子
- 案例化讲解
- 关键判断点
- 行动建议
- 结尾引导

五、公众号长文大纲
- 标题
- 导语
- 正文结构
- 法律依据
- 操作建议

六、合规自查
请检查是否存在以下问题:
1. 是否有“包赢、一定赔、百分百违法”等绝对化表述;
2. 是否把个案结论说成通用结论;
3. 是否缺少适用前提;
4. 是否存在诱导诉讼或夸大风险;
5. 是否有需要人工律师复核的内容。

要求:
不要编造法律依据。
不确定的信息必须标注“需人工复核”。
表达要适合普通用户阅读,但法律判断必须严谨。来源说明:本文整理自 TraeWork 官方知识库,仅用于个人学习与参考。TraeWork 为字节跳动旗下 AI 办公平台。如涉及版权或官方更新,请以官方发布为准。