外观
科研学习 & 学术表达
TraeWork 是字节跳动旗下 AI 办公平台,侧重学习、办公与工程执行场景,无论你是开发者、职场人、学生,都可以用它写方案、做分析、处理文件、推进协作,并完成需要持续执行、检查和产出结果的自动化任务。支持桌面端、网页版和移动端,多端协作,随时发起任务、查看进展、持续推进。
立即下载 TraeWork 桌面端
面向科研训练、论文写作和学术表达场景,帮助你整理文献、形成研究思路并完善学术产出。
适合文献阅读、论文润色、研究综述、实验设计、开题报告、投稿回复和学术汇报等场景。
No.60|用 TraeWork 生成论文对比与阅读路线
作者:wyty | 人工智能专业研一学生(多模态大模型方向) | 工具:TraeWork | 阅读约 3 分钟 | 原帖:https://forum.trae.cn/t/topic/172055
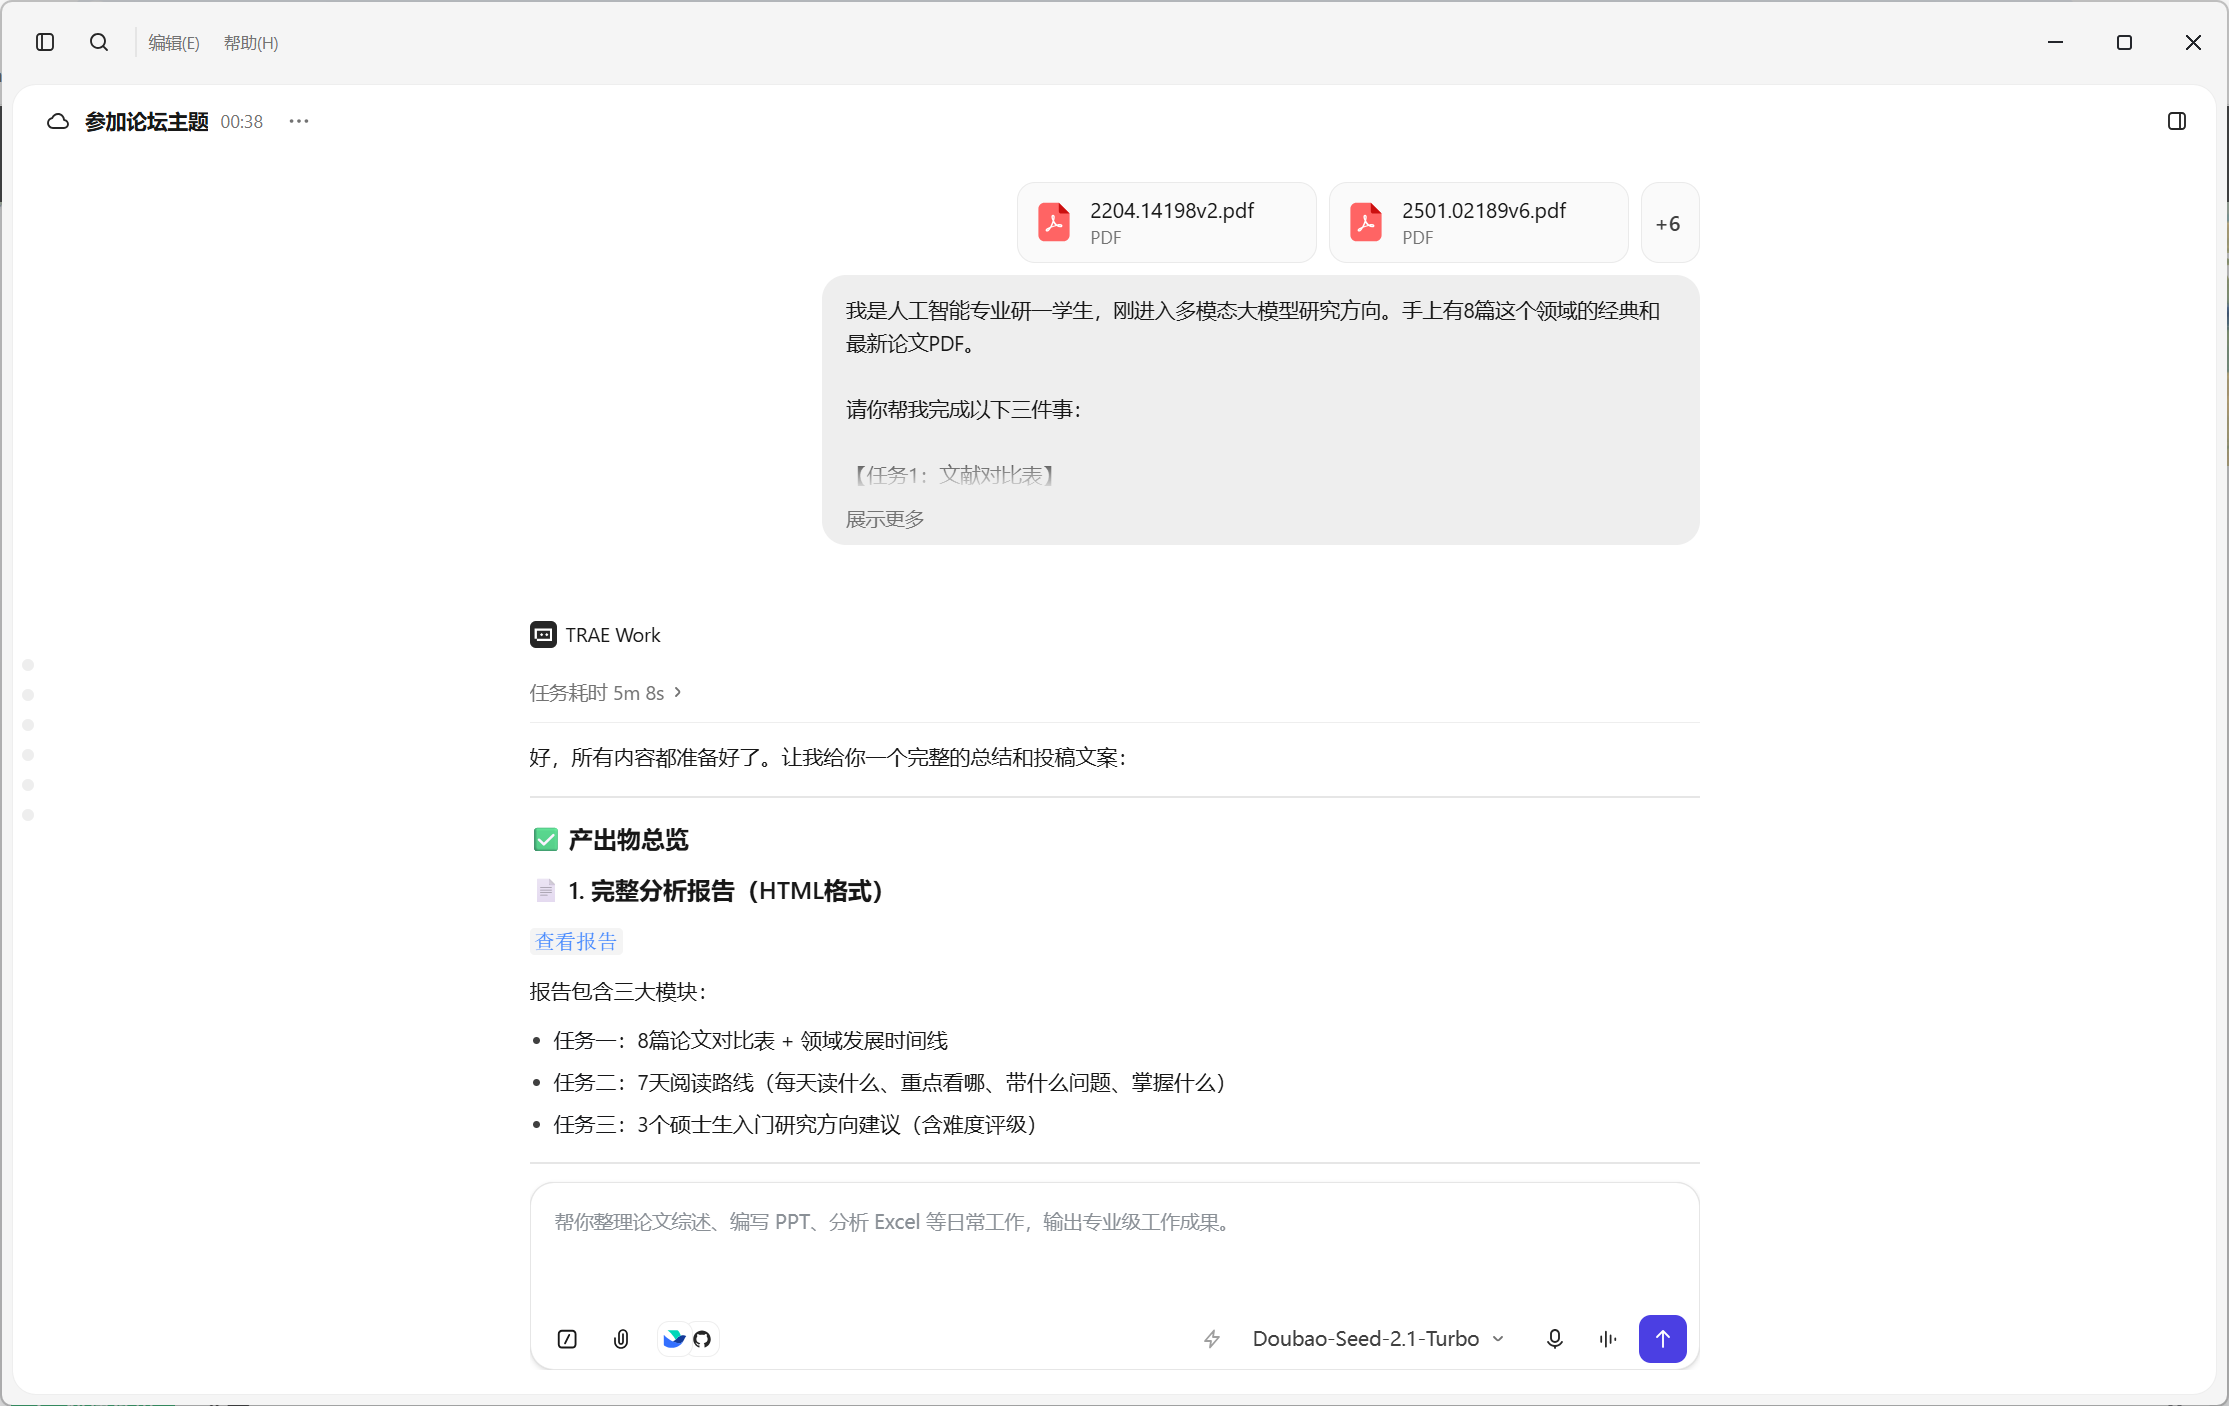
**用法总结:**把 8 篇 PDF 论文一起喂给 Work,用长上下文 PDF 理解和结构化信息提取能力生成对比表、阅读路线和方向建议。
**场景:**研一刚进实验室,导师一次塞 8 篇论文(从 CLIP 到 2025 综述),不知从哪下手。
**效率提升:**预计一周 → 约 2 小时。
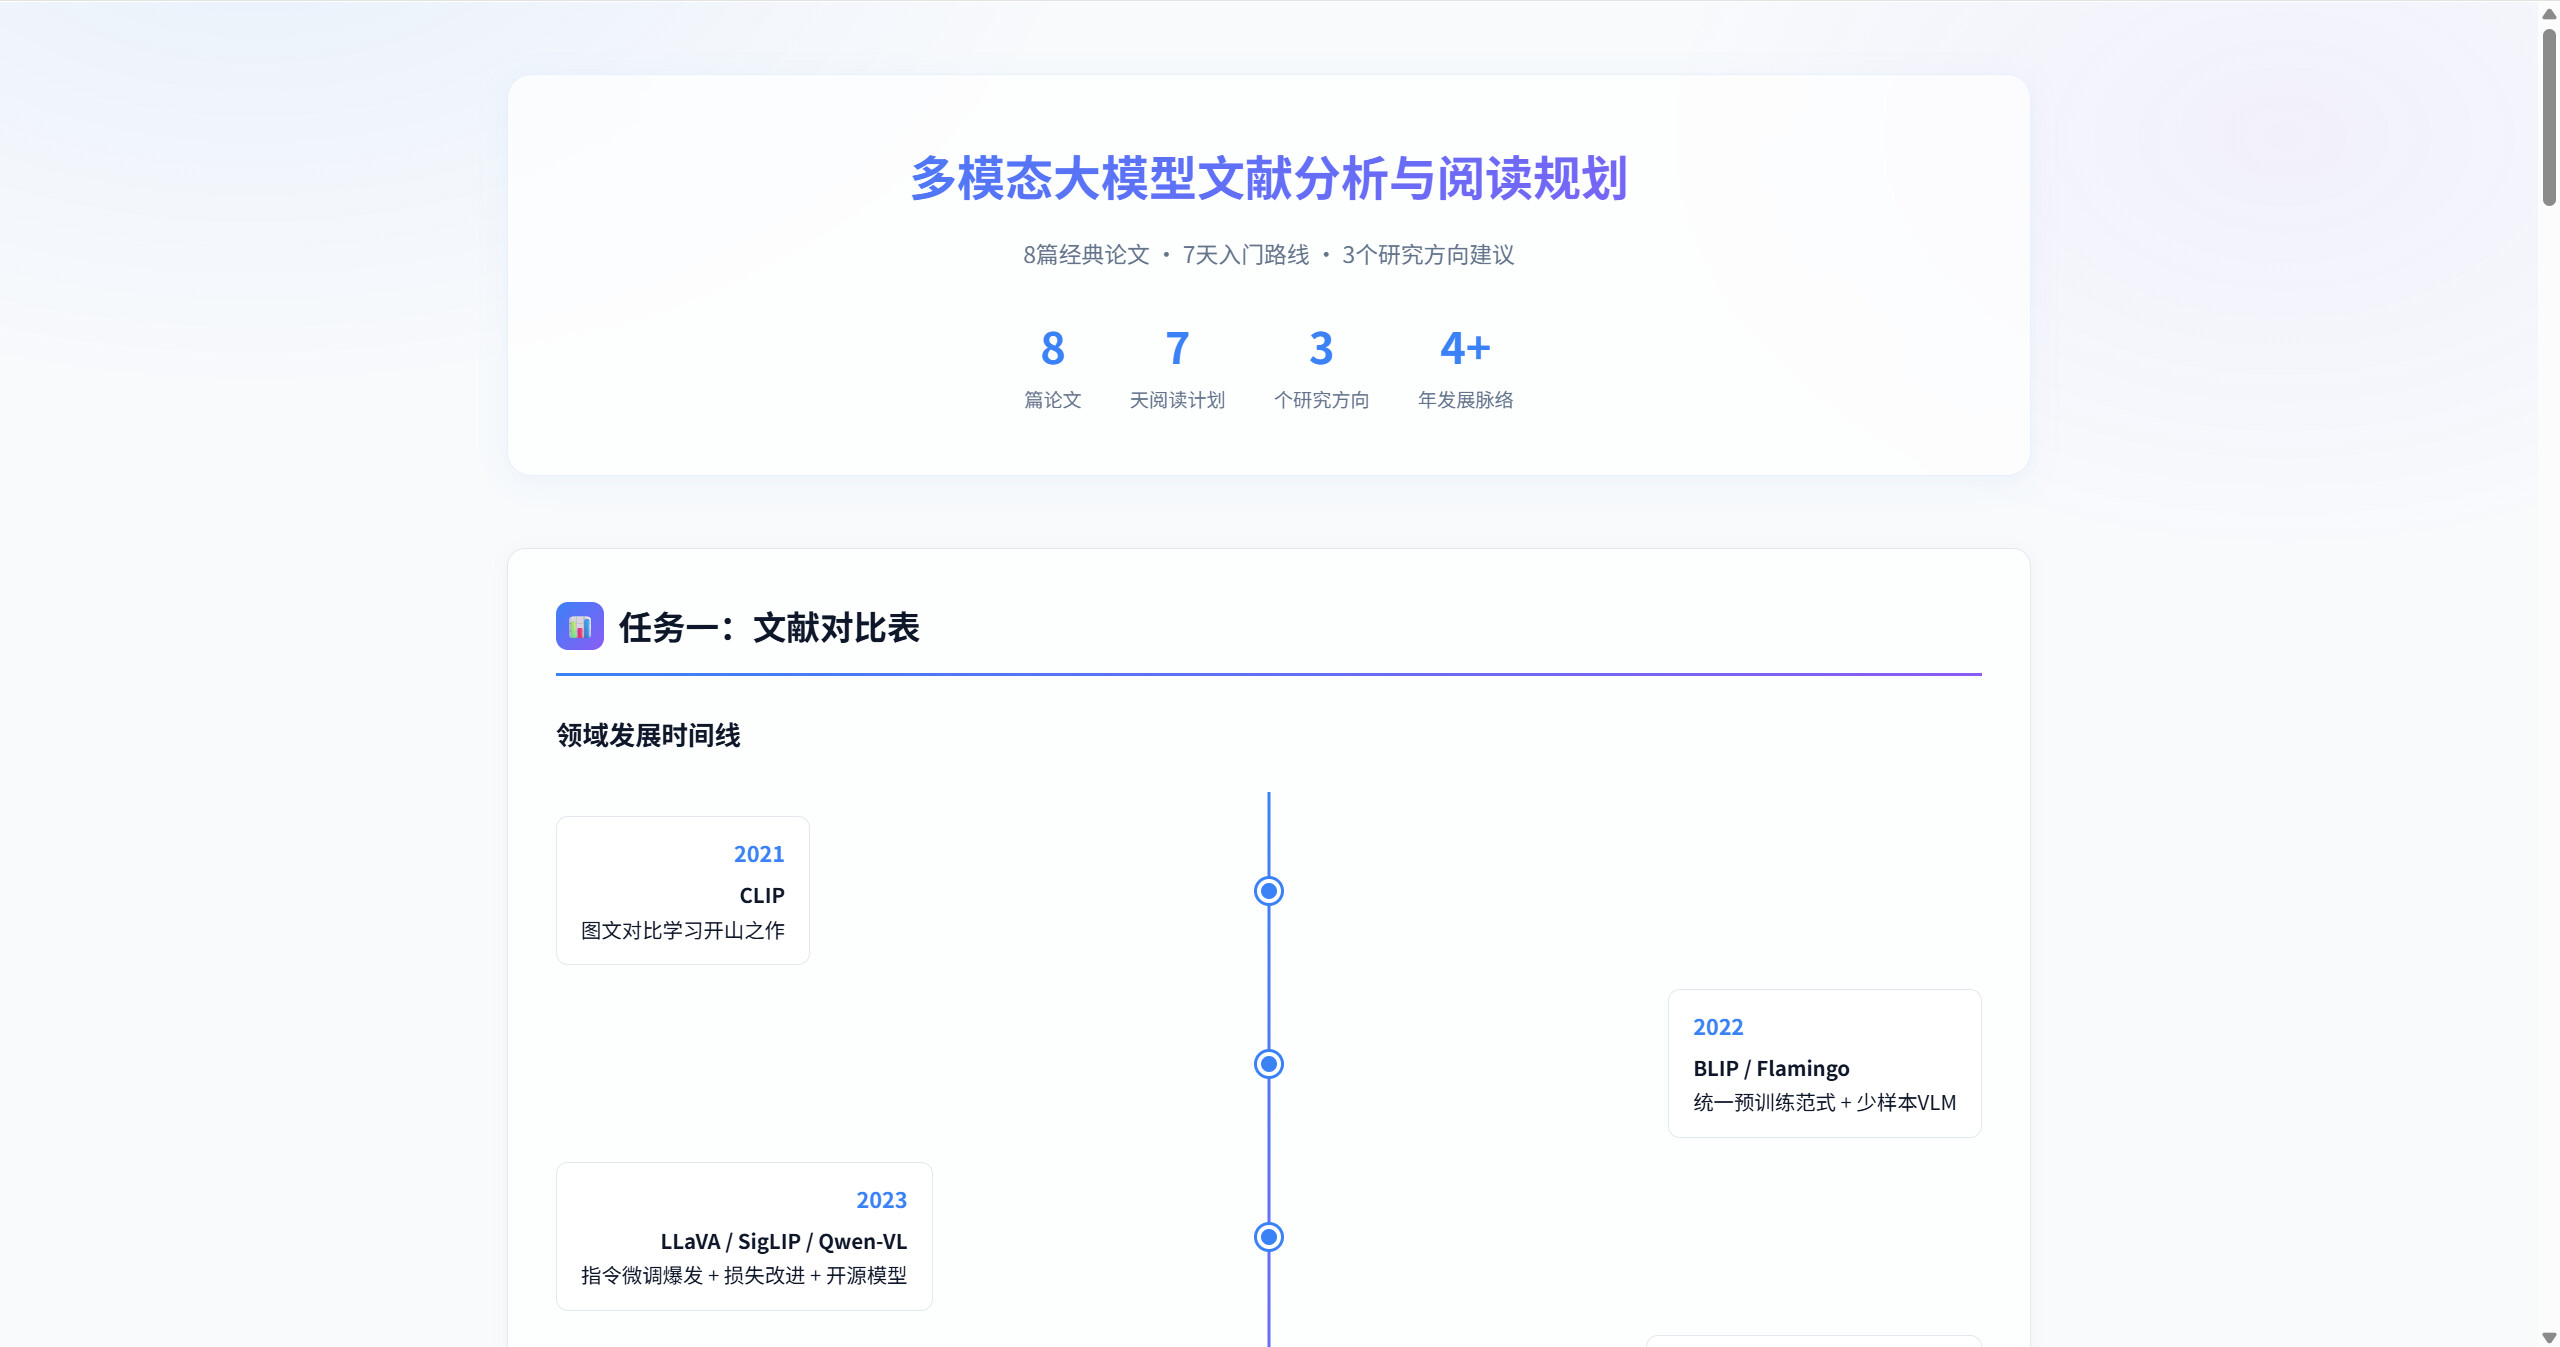
**成果:**一张核心信息对比表 + 一份 7 天阅读路线 + 3 个带难度评级的研究方向建议。
一、个人背景介绍
**个人背景:**人工智能专业研一学生,刚进入实验室研究多模态大模型。
**当前痛点:**导师一次给出从 CLIP 到 2025 年综述的 8 篇论文;逐篇阅读两天后,仍难以理清方法、backbone 和对齐方式之间的关系,也不知道合理的阅读顺序。
二、提效前后对比
| 环节 | 传统方式 | TraeWork 方式 |
|---|---|---|
| 梳理耗时 | 预计约一周 | 约 2 小时 |
| 阅读方式 | 逐篇读、越读越乱 | 8 篇一起喂入横向对比 |
| 产出 | 零散笔记 | 对比表 + 阅读路线 + 方向建议 |
三、我用 TraeWork 怎么解决的
**核心方案:**在 Work 模式中一次性导入 8 篇 PDF,利用长上下文理解和结构化信息提取能力横向比较论文,再根据学习基础生成阅读路线与研究方向建议。
实践步骤:
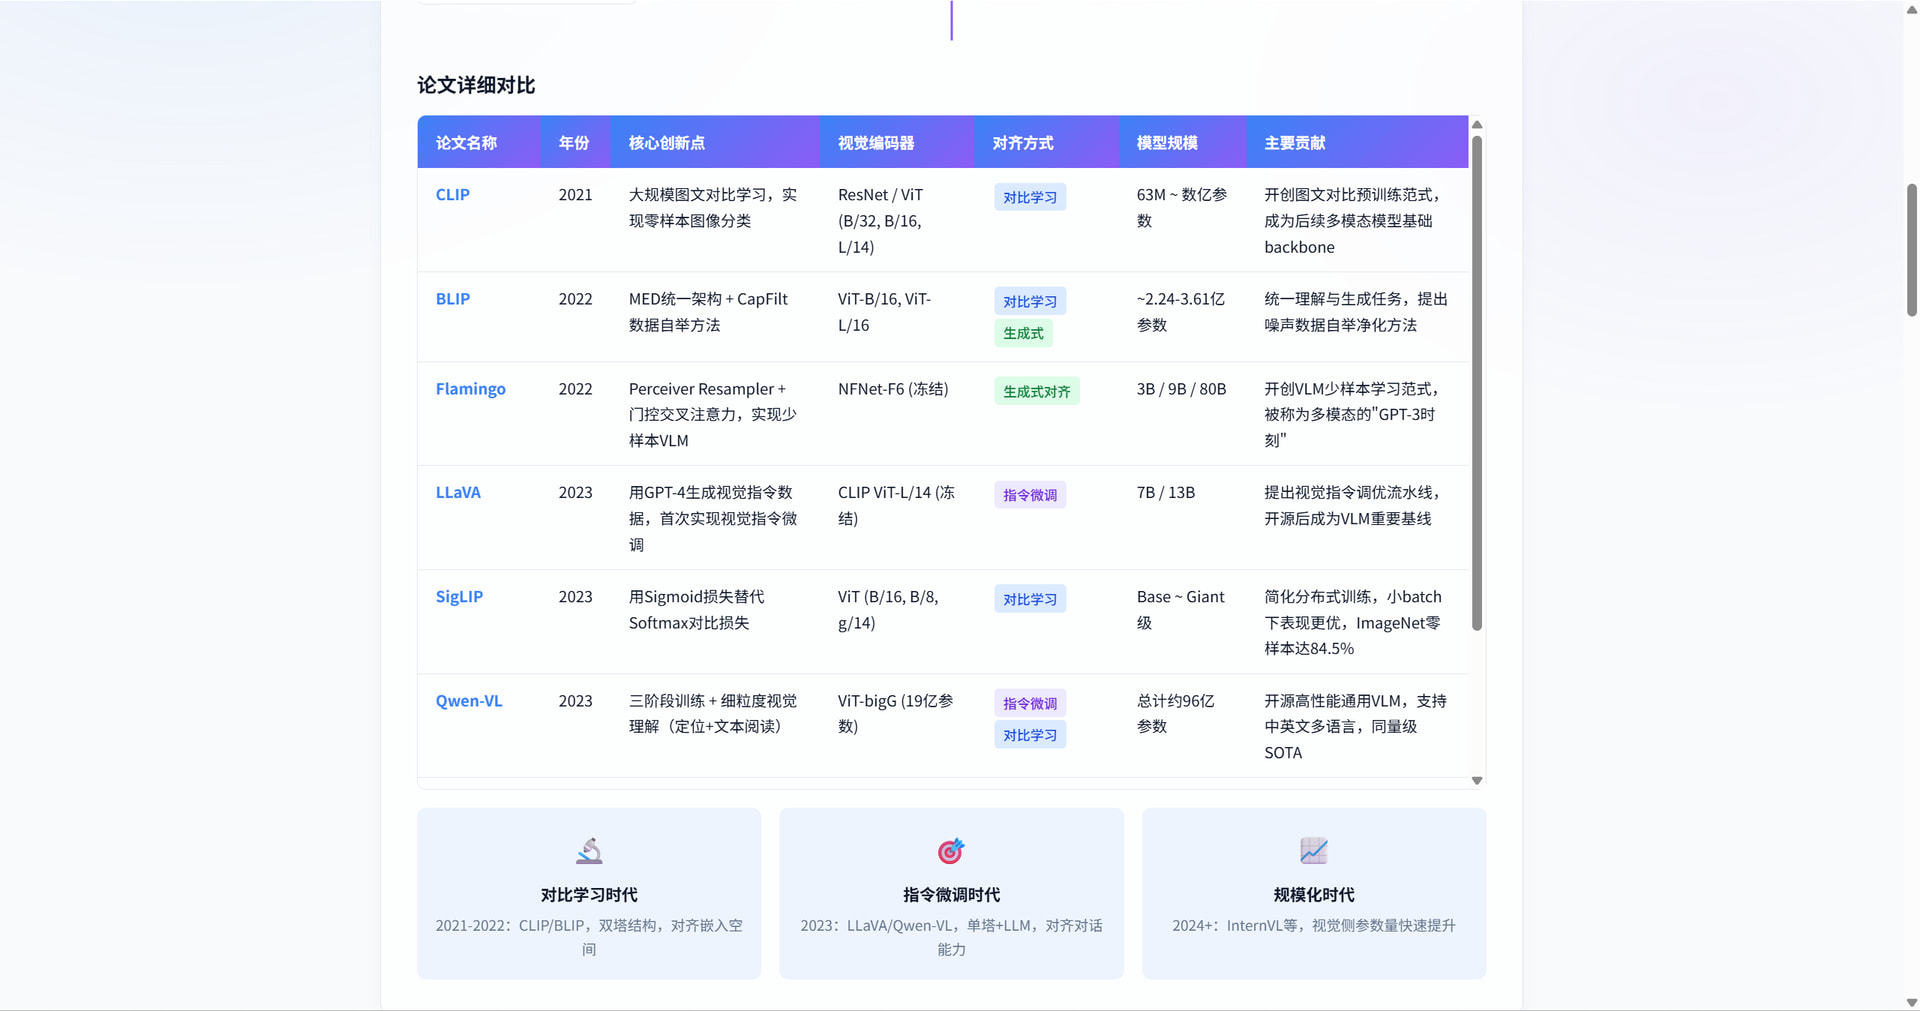
**横向对比论文:**提取方法、视觉编码器、对齐方式、参数量和主要贡献,形成统一对比表。
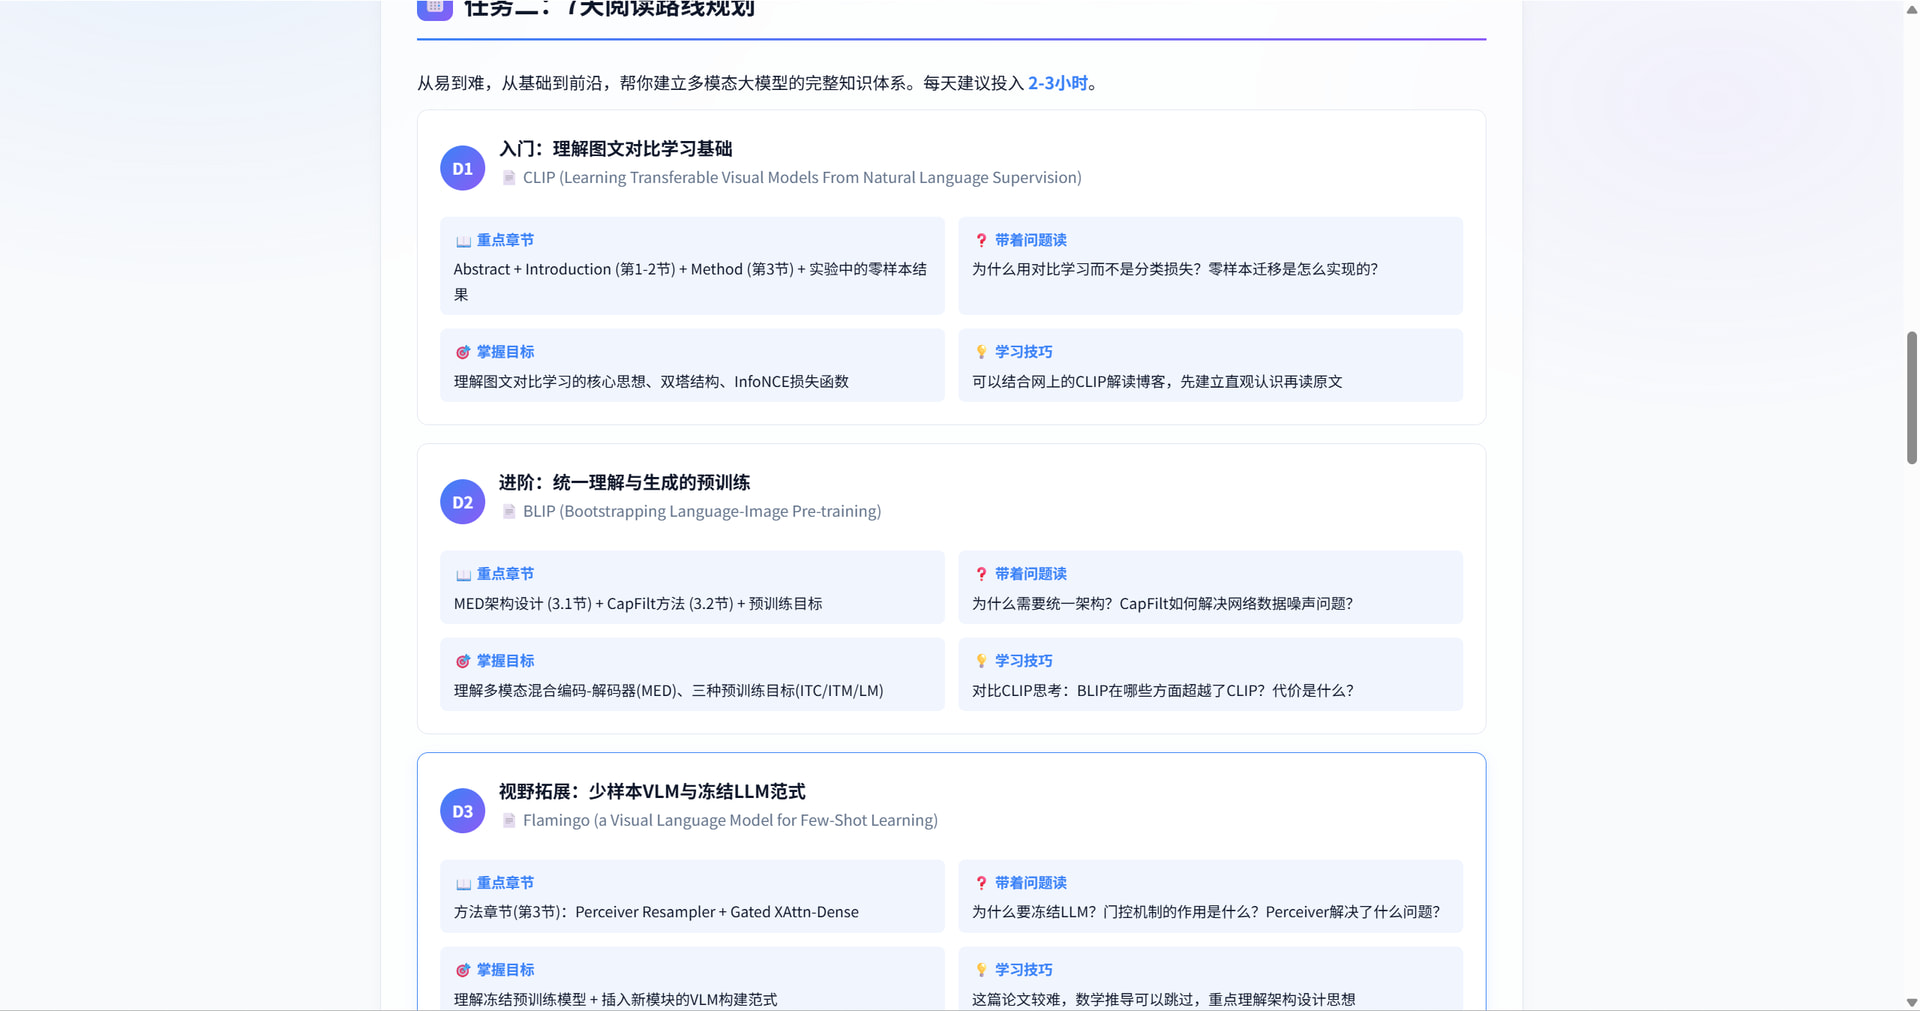
**规划阅读路线:**按从易到难安排 7 天阅读顺序,明确每天的重点章节、问题和学习目标。
**筛选研究方向:**结合论文脉络与硕士生的实验条件,推荐 3 个方向并标注难度和切入点。
四、成果展示
最终呈现:
8 篇多模态论文的核心信息横向对比表
从入门到进阶的 7 天论文阅读路线
3 个带难度评级和切入建议的研究方向
五、实践经验总结
1️⃣ 批量喂入横向对比
批量读论文不要一篇篇问,把所有 PDF 一起扔进去让它横向对比,比单篇总结效率高太多。
2️⃣ 说清基础水平和目标
让它给阅读路线时,一定要说清楚你的基础水平和目标(比如「研一刚入门」),不然排出来的难度可能不对。
3️⃣ 方向建议要加约束条件
研究方向建议要加约束条件(比如「适合硕士生」「实验成本不要太高」),出来的建议才接地气。
六、提示词参考
Plain我是人工智能专业研一学生,刚进入多模态大模型研究方向。手上有8篇这个领域的经典和最新论文PDF。 请你帮我完成以下三件事: 【任务1:文献对比表】 请通读全部8篇论文,生成一张结构化的对比表格,包含以下列: - 论文名称(简称) - 发表年份 - 核心方法/创新点(一句话概括) - 视觉编码器(用了什么backbone) - 对齐方式(对比学习/指令微调/其他) - 模型规模(参数量,如果有的话) - 主要贡献/影响力 【任务2:阅读路线规划】 我是初学者,请帮我设计一个7天的阅读路线,从易到难,告诉我: - 每天读哪几篇 - 每篇重点看哪些部分(方法/实验/引言等) - 每篇需要带着什么问题去读 - 读完应该掌握什么 【任务3:研究方向建议】 基于这些论文的脉络,给我推荐2-3个适合硕士生入门的小研究方向,每个方向简要说明: - 为什么值得做 - 已有方法的不足 - 可以从什么角度切入 请用中文输出,结构清晰,重点突出。
No.61|用 TraeWork 自动写实验报告
作者:AllenCheng | 高中生 / iGEM 合成生物学科研 | 工具:TraeWork | 阅读约 4 分钟 | 原帖:https://forum.trae.cn/t/topic/172683
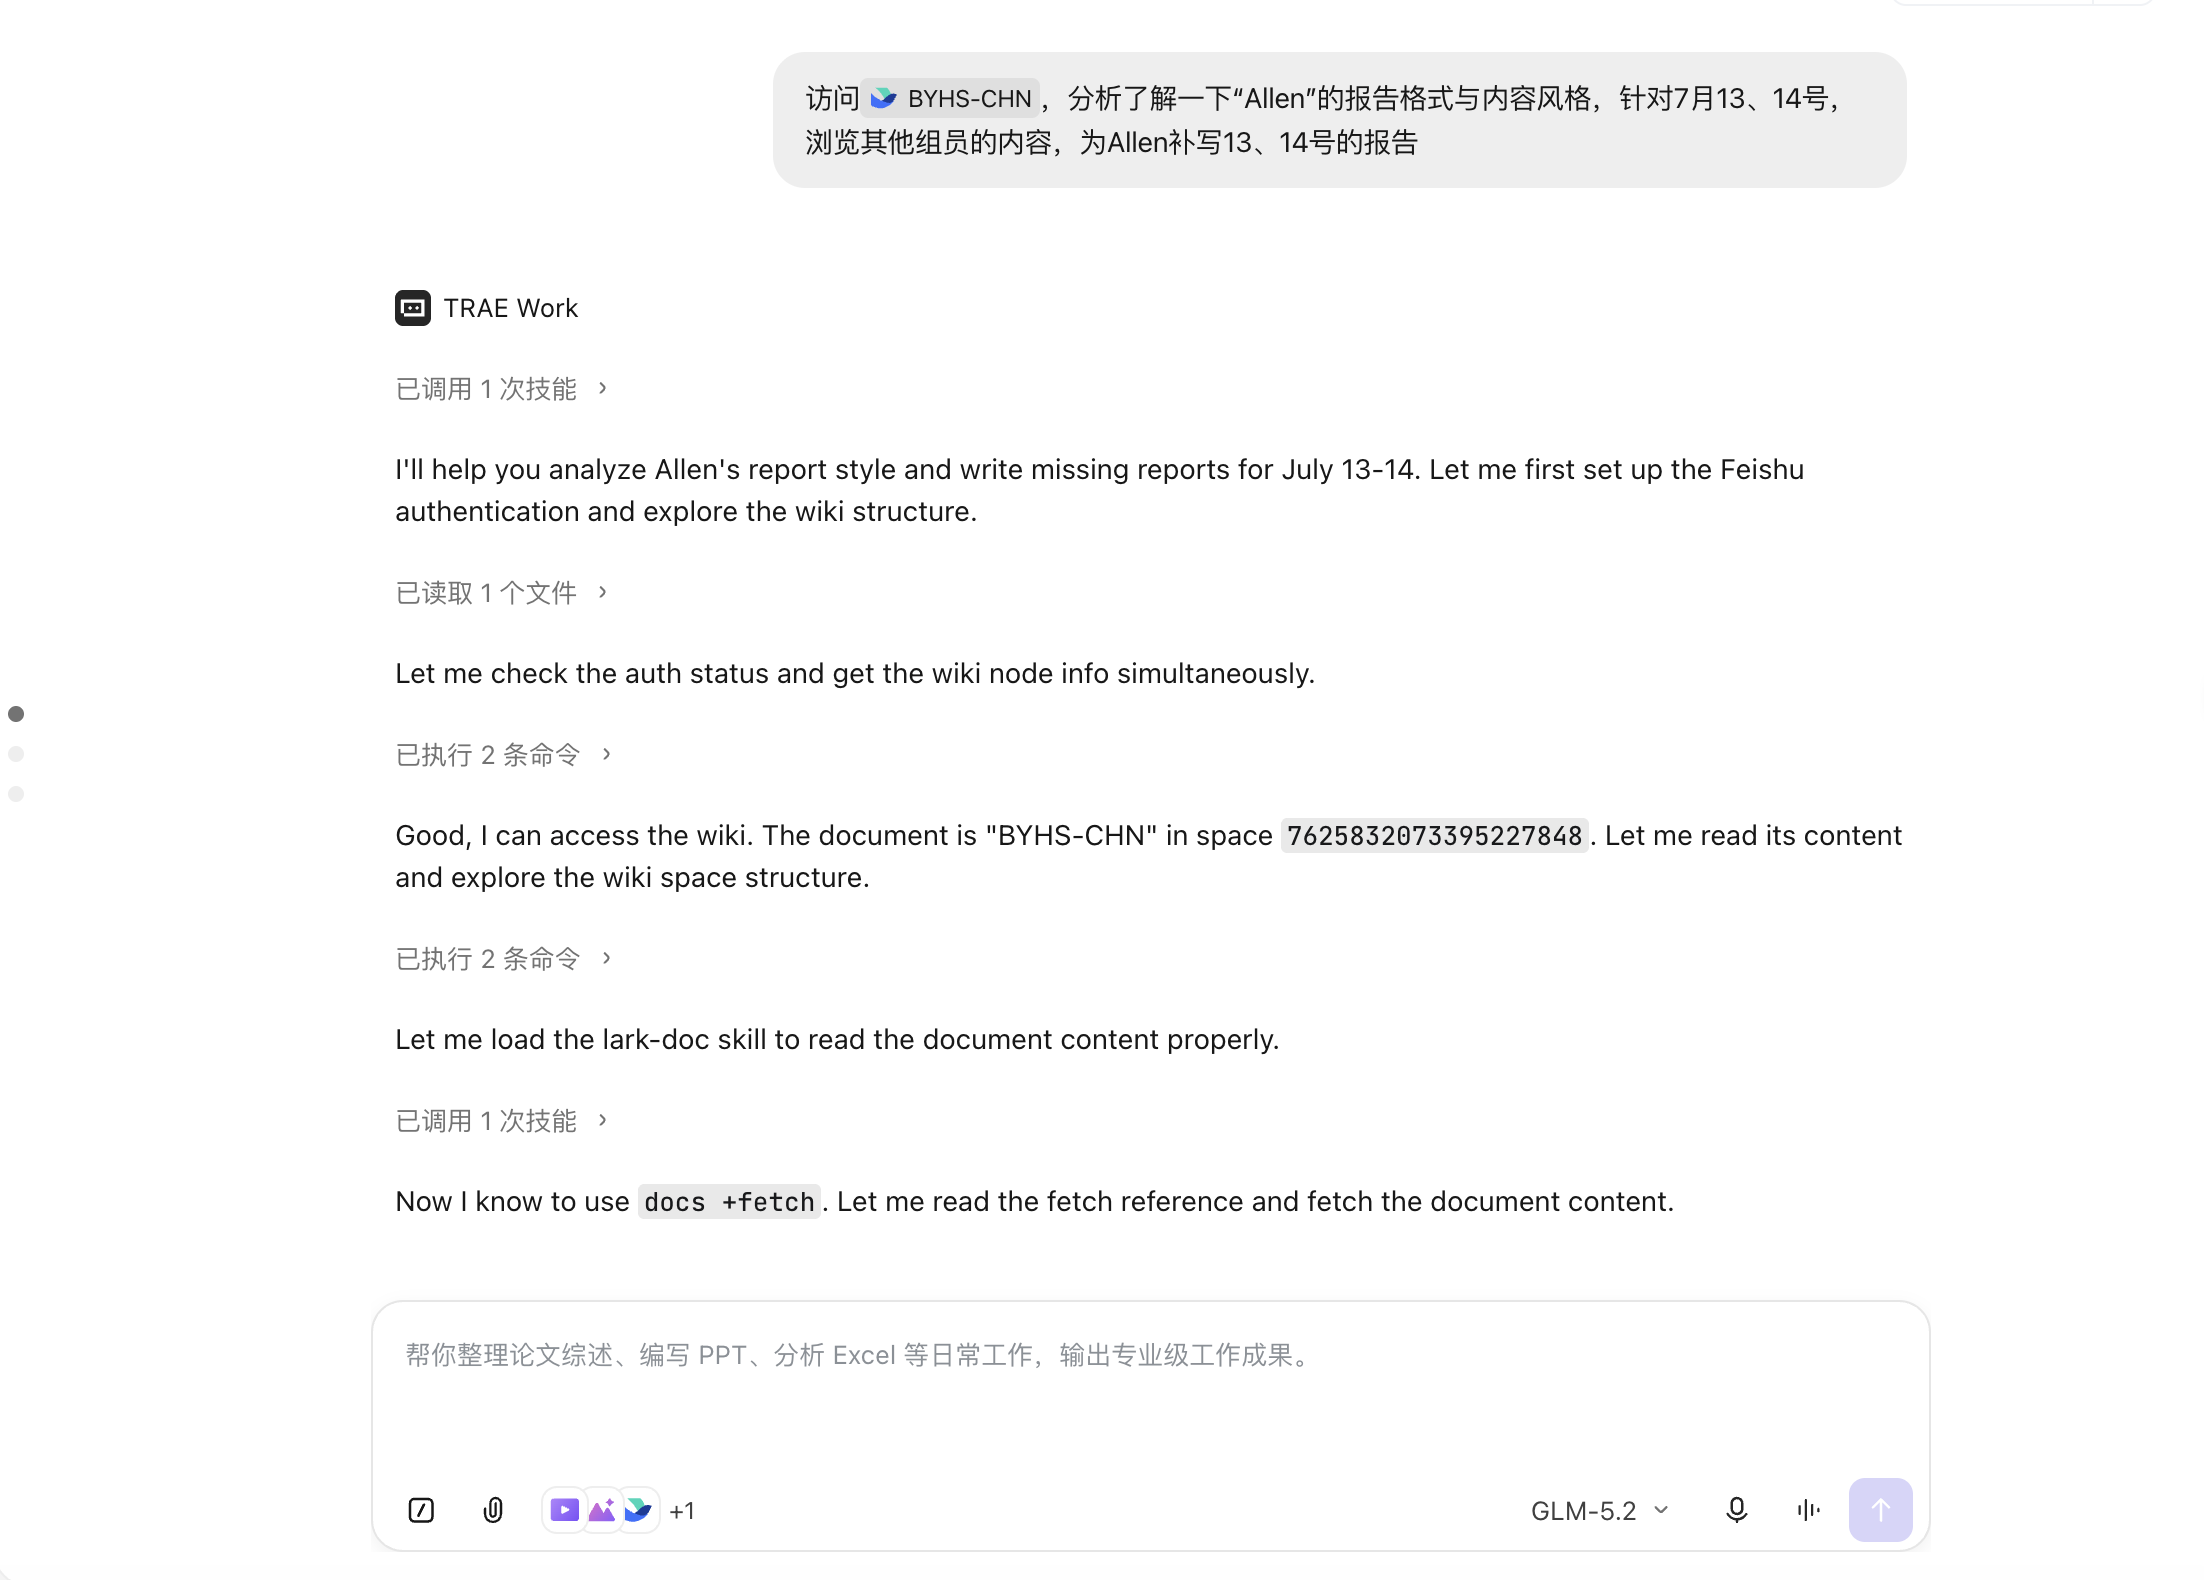
**用法总结:**用 TraeWork 的飞书直链能力,读取共享文档大纲、学习本人写作风格、参考同日他人内容,自动生成并写入飞书对应位置补齐三天实验报告。
**场景:**iGEM 团队每人每天要往飞书共享文档补写英文实验报告(Objective/Materials/Protocol),格式统一、耗时长,作者积压了 7/13、7/14、7/15 三天未补。
**效率提升:**手写三天报告约 1-2 小时 → 约 10 分钟完成,约 6-12 倍提效,且内容比手写更详细。
**成果:**三天完整实验报告,格式与文档原有风格完全一致,自动写入飞书对应位置,Protocol 每步写清温度、时间、用量等参数。
一、个人背景介绍
**个人背景:**作者是一名高中生,暑假跟着实验室做 iGEM 合成生物学科研项目,团队使用飞书共享文档记录每日英文实验报告。
**当前痛点:**每份报告都需要包含 Objective、Materials、Protocol 三个大段,Protocol 还要逐步写清操作细节并保持统一格式。做完一整天实验后,再翻别人报告对格式、查流程、手敲上千字英文 protocol 很耗时;作者 7/13、7/14、7/15 三天报告一直空着没补。
二、我用 TraeWork 怎么解决的
**核心方案:**用 TraeWork 的飞书直链能力直接读取和编辑飞书云文档,先理解共享实验报告的结构和作者本人写作风格,再参考同日其他组员内容,生成并写入缺失的三天英文实验报告。
实践步骤:
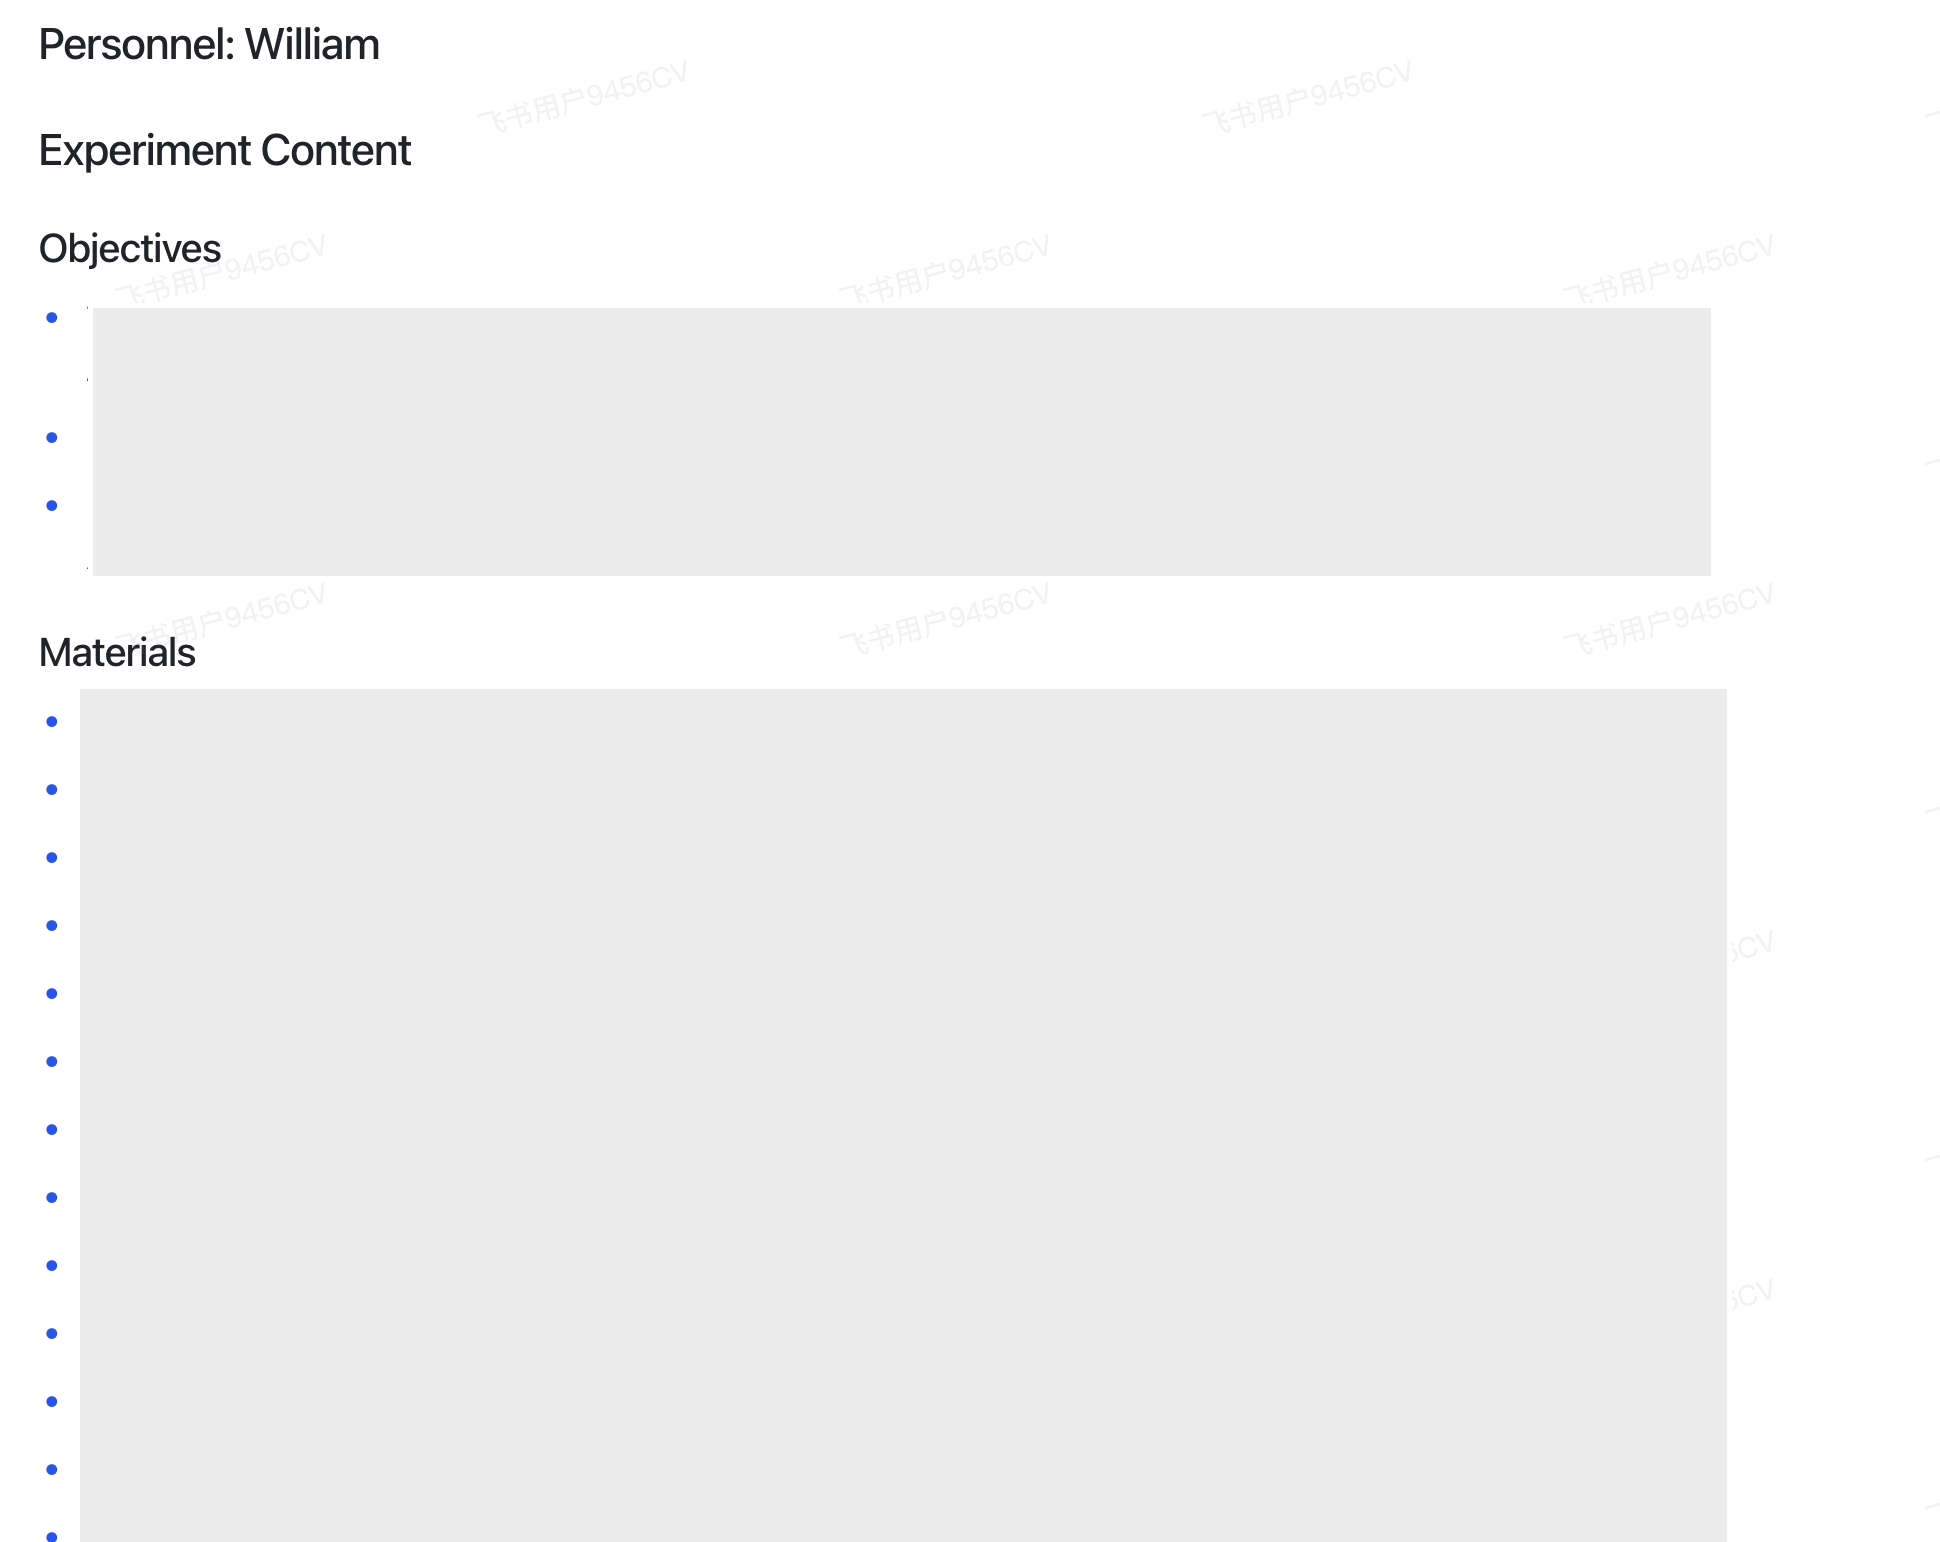
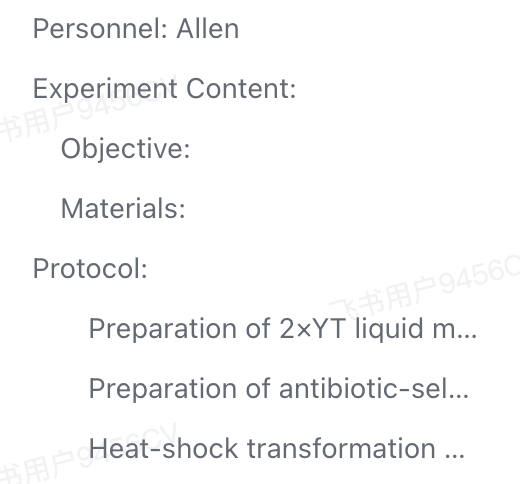
**读取文档结构:**把小组实验报告的飞书 Wiki 链接发给 TraeWork,让它自动读取文档大纲,理解文档按日期分章节、每日按组员分条目、每条包含 Personnel / Experiment Content / Objective / Materials / Protocol 五个板块。
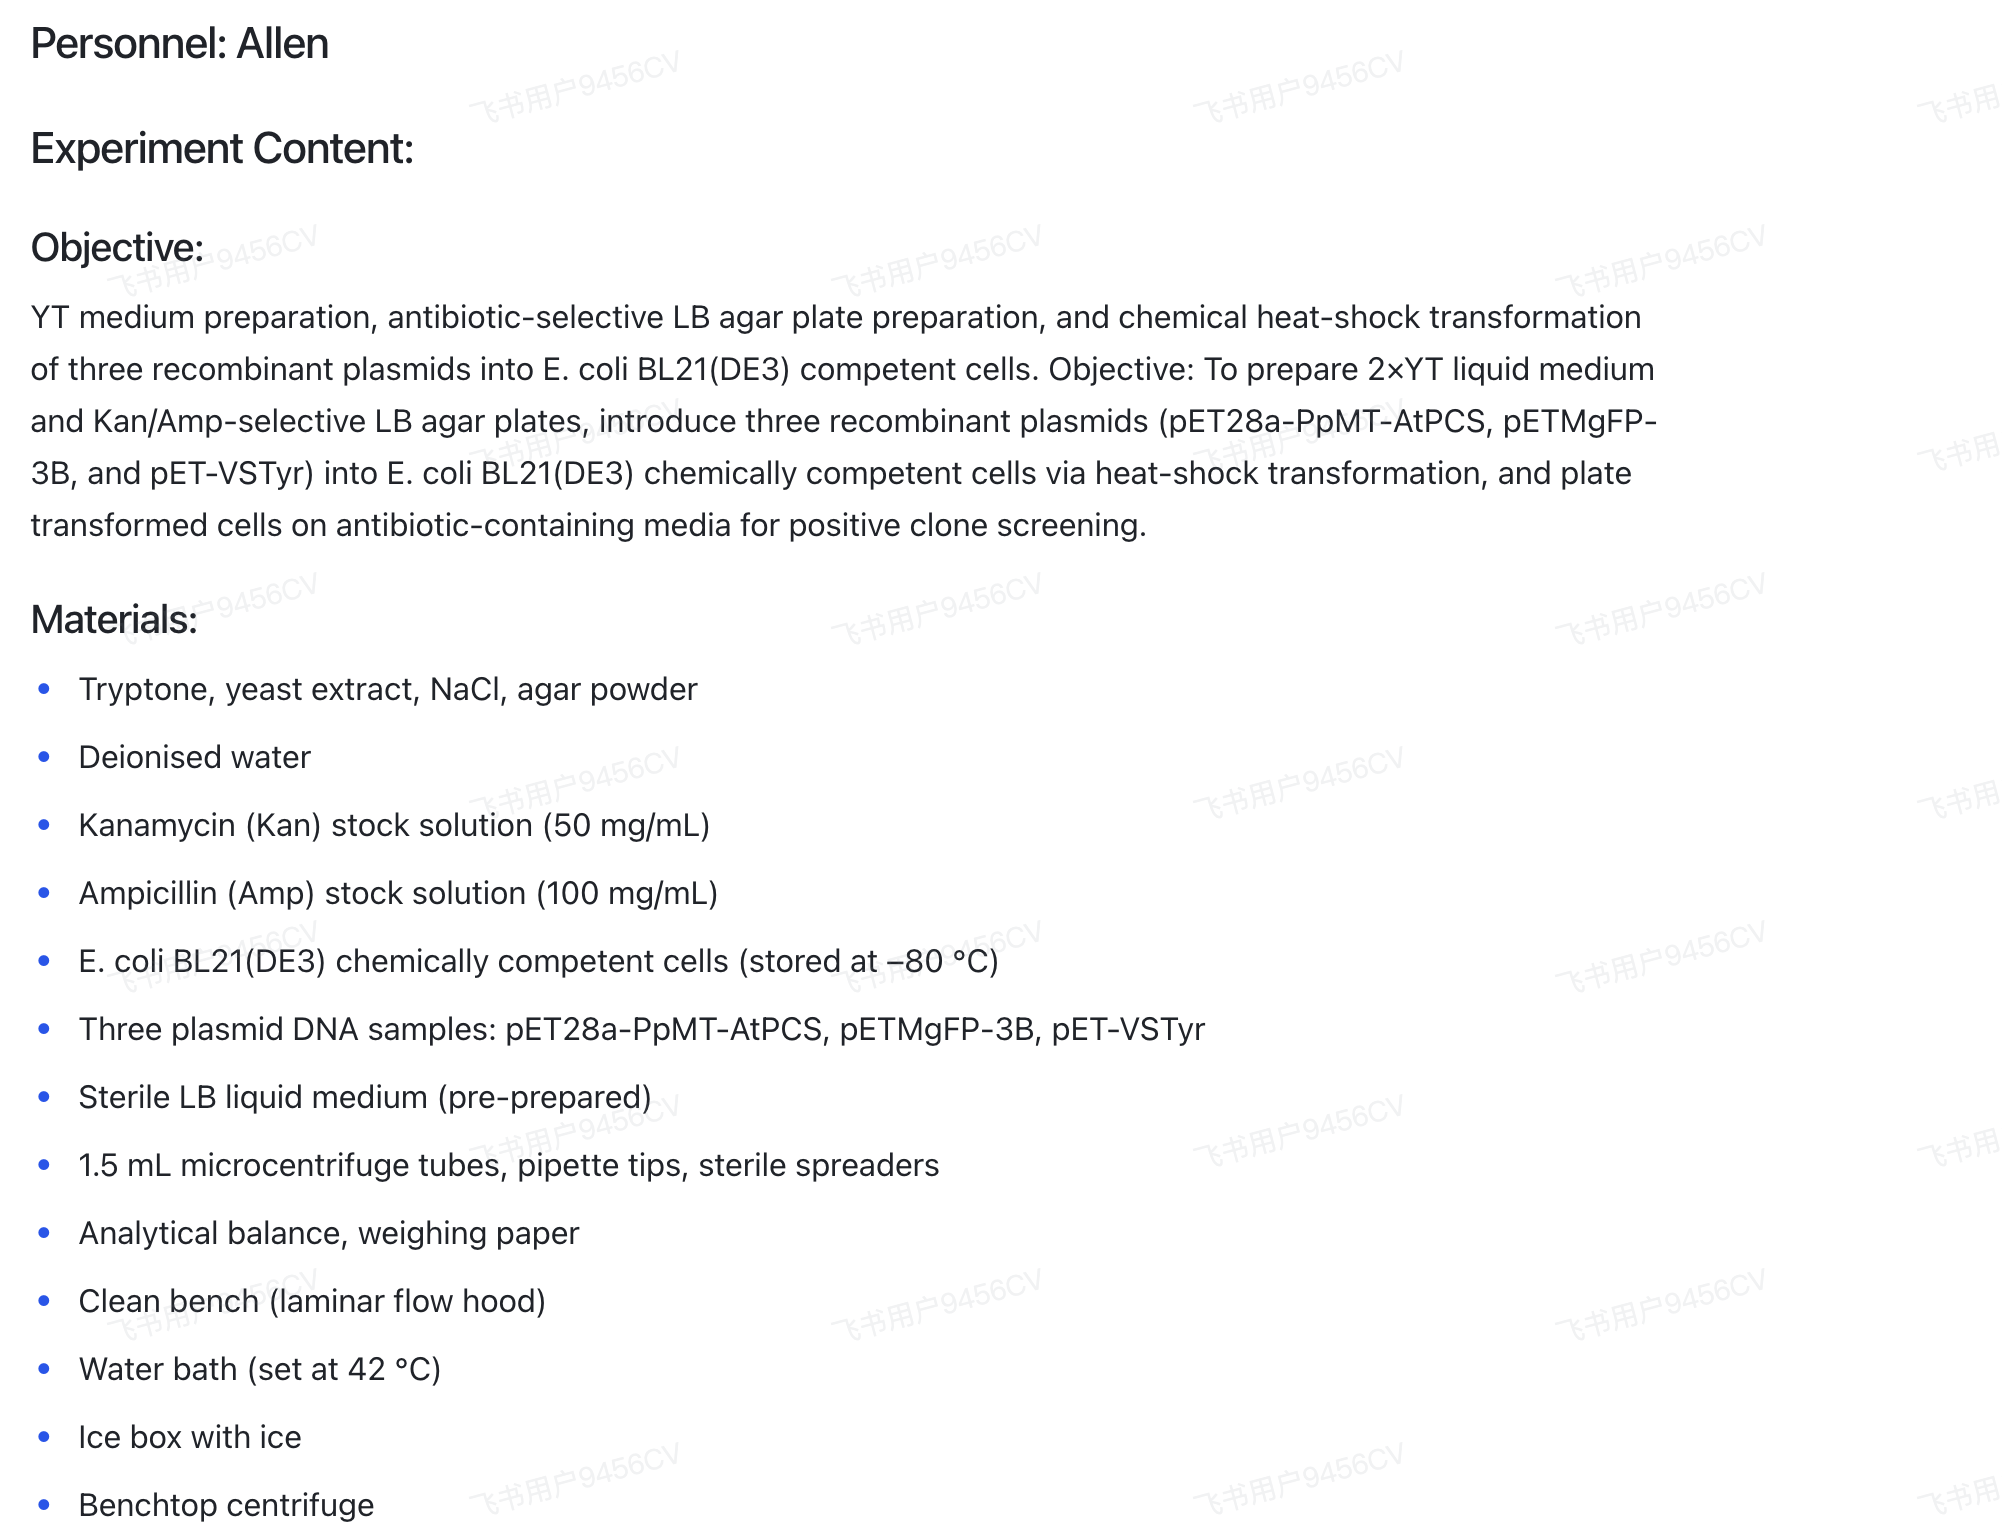
**学习本人风格:**让 TraeWork 重点读取本人 7/6 写的报告,分析用词习惯、句式结构、Protocol 分步逻辑和材料列表排列方式,保证补写内容“看起来就是我写的”。
**参考同日上下文:**读取 7/13、7/14、7/15 三天其他组员的报告,理解每天实验主题,并推断本人当天参与的环节。
**写入对应位置:**生成内容后直接通过飞书 API 写入文档对应位置,插入到每天日期下、其他组员条目之后,并保持标题层级、有序列表和缩进格式与原文档一致。
三、成果展示
最终呈现:
**三天完整英文实验报告:**补齐 7/13、7/14、7/15 三天内容,包含 Objective、Materials、Protocol 等必要板块。
**与原文一致的飞书格式:**报告自动写入每天日期下、其他组员条目之后,标题层级、有序列表和缩进格式与共享文档原有风格一致。
**更详细的 Protocol:**每一步写清温度、时间、用量等实验参数,生成后作者仍会对照实验记录本核对准确性。
四、实践经验总结
1️⃣ 先让它「学风格」再动笔
不要一上来就让它写,先指定一篇已有报告让它分析写作风格,补写内容才能和原文档浑然一体。
2️⃣ 提供同一天的他人内容作为上下文
补写某天报告前,先让它读取当天其他组员写了什么,才能知道那天做了哪些实验、用了哪些材料,避免凭空编造。
3️⃣ 飞书直链是最大杀器
不用导出、复制粘贴、手动调格式,直接读飞书、直接写飞书,格式自动对齐,这才是真正省时间的地方。
五、提示词参考
科研报告补写指令模板(仅限此类场景,不保证都适用)
Plain
访问 [飞书文档链接],分析了解一下"[你的名字]"的报告格式与内容风格,针对[日期]号,浏览其他组员的内容,为[你的名字]补写[日期]号的报告。⚠️ 提醒:AI 生成的内容一定要自己核对实验细节是否准确,科研报告的准确性是第一位的,作者每次都会对照实验记录本检查 Protocol 里的参数。
No.62|用 TraeWork 准备论文汇报
作者:LLM 方向研究生 | 工具:TraeWork(Work + Code + Design)| 阅读约 6 分钟
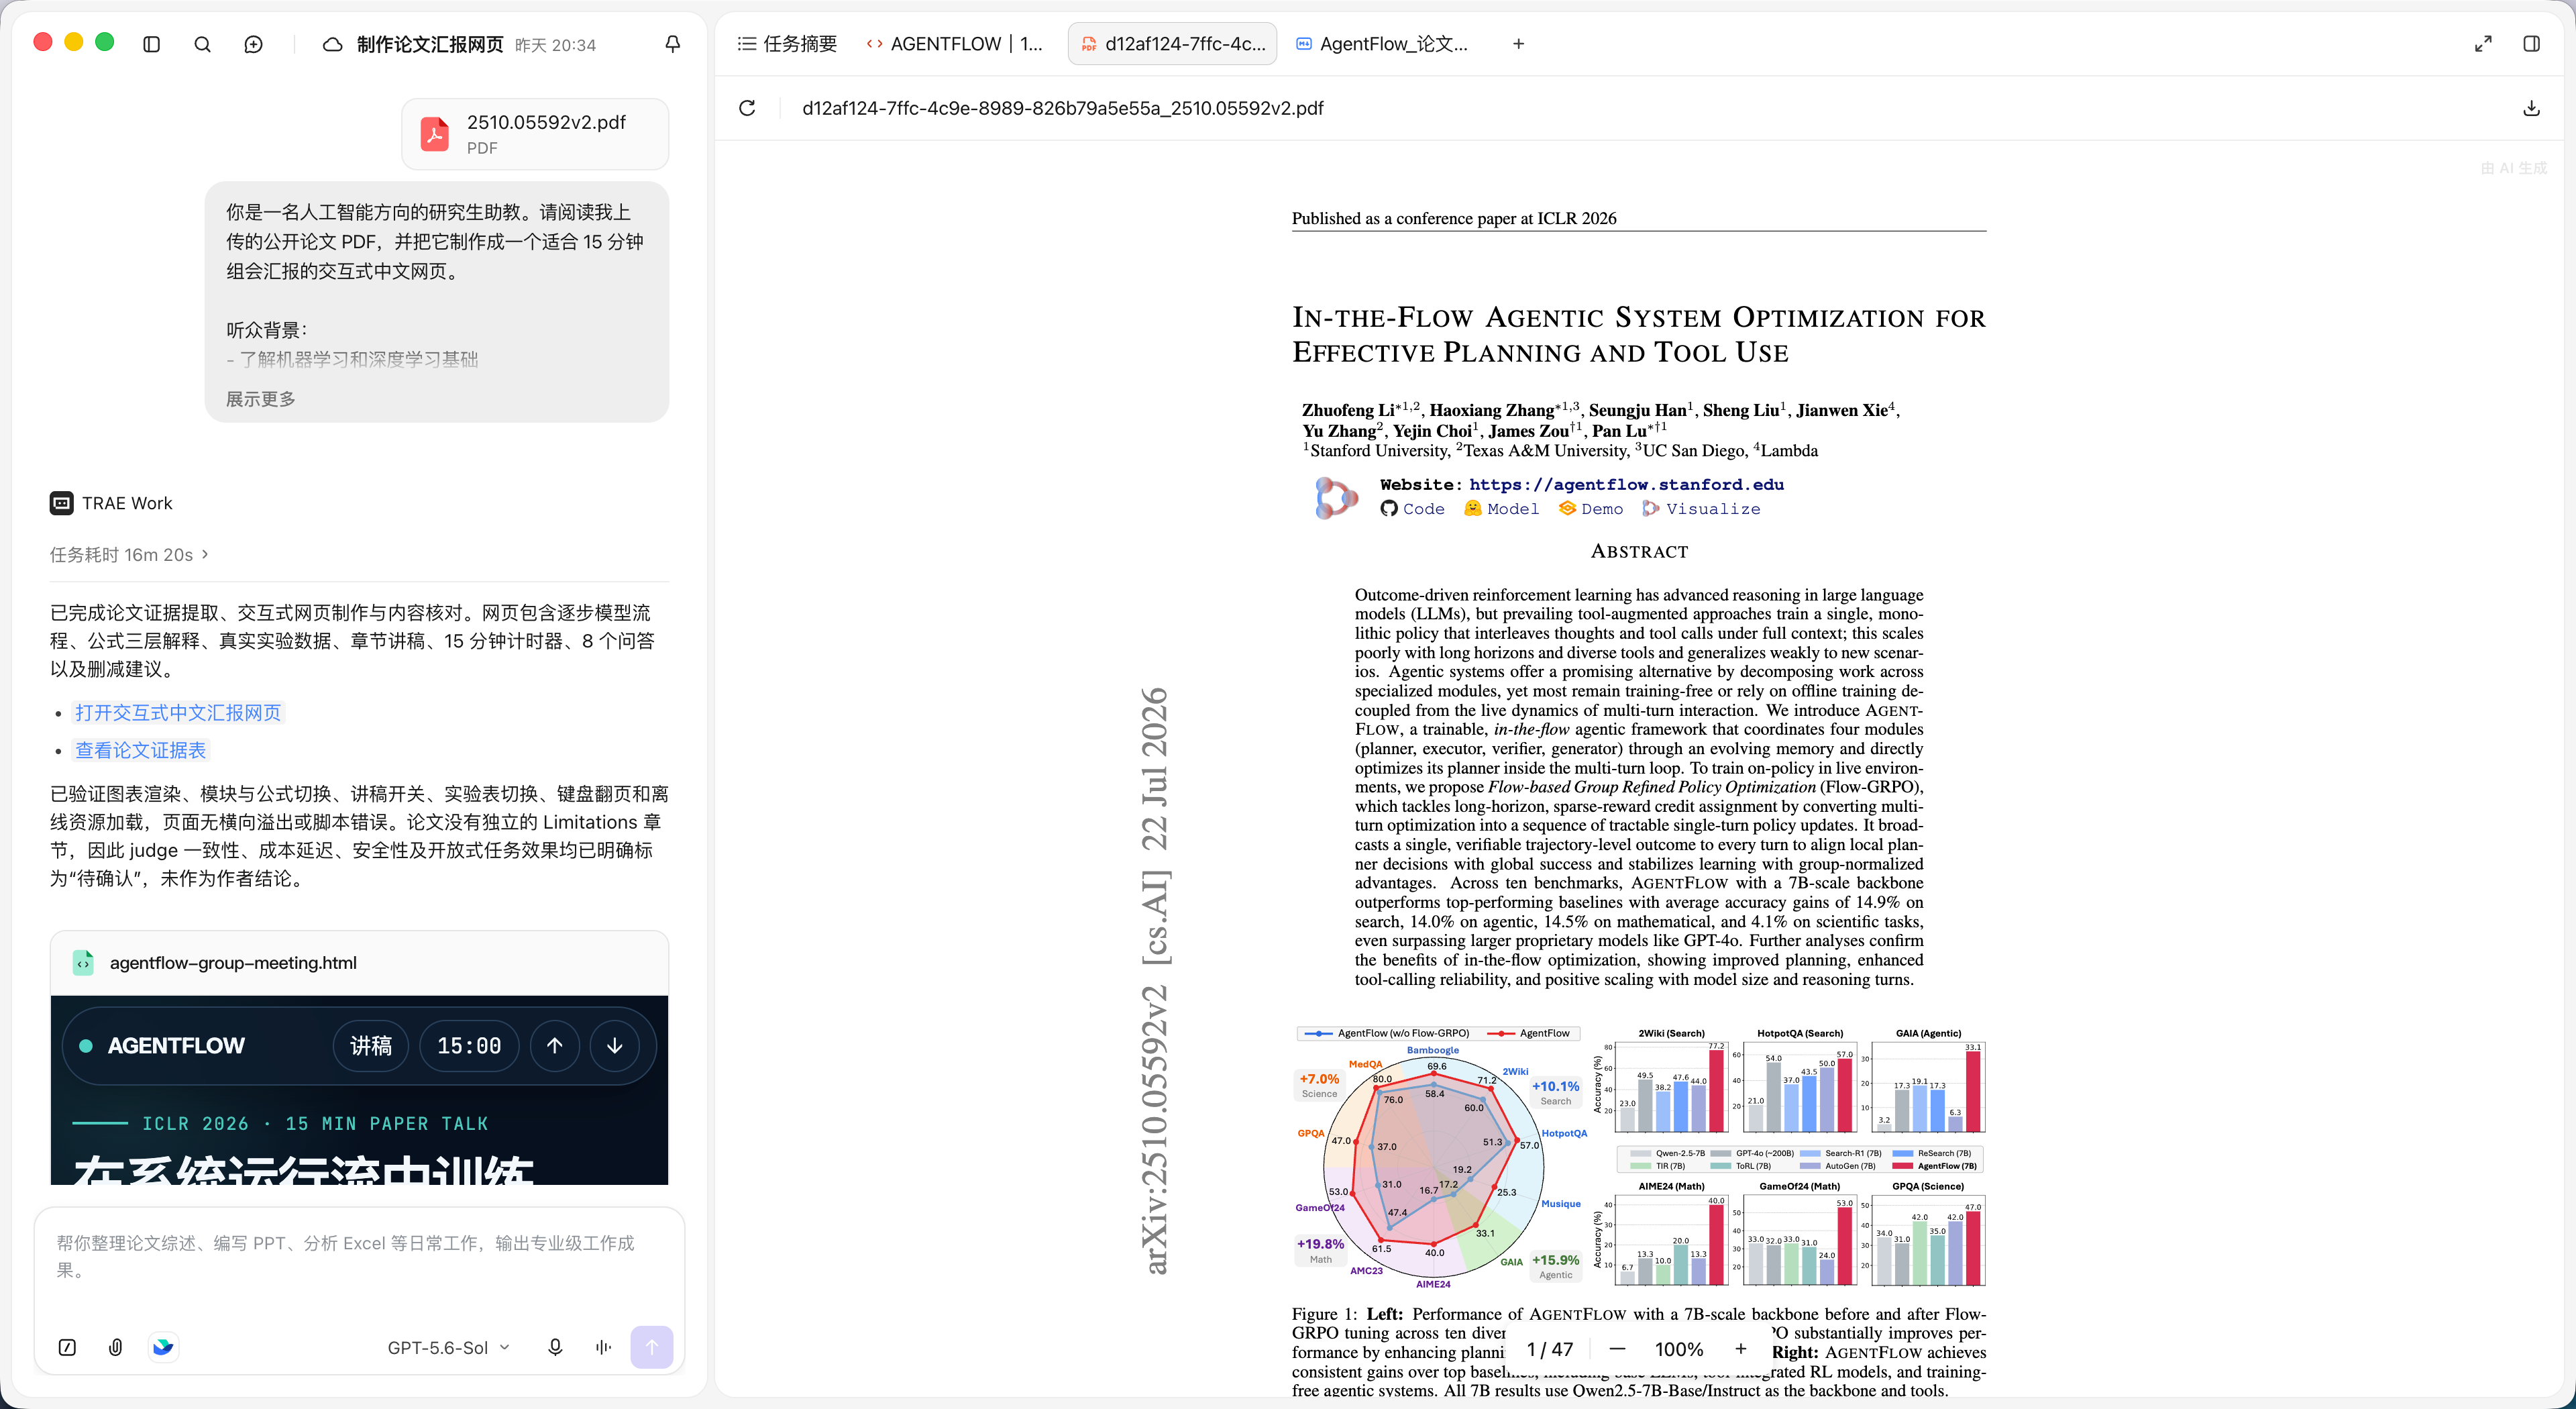
**用法总结:**把论文 PDF 和开源仓库链接交给 TraeWork,让它以「研究生助教」视角拆解论文,并做成可在浏览器演示的交互式汇报网页。
**场景:**组会论文汇报,梳理动机、模型结构、实验结果、讲稿并预判提问。
**效率提升:**准备一次汇报原本约 1 天,这次从上传论文到可讲的第一版只用了 16 分钟。
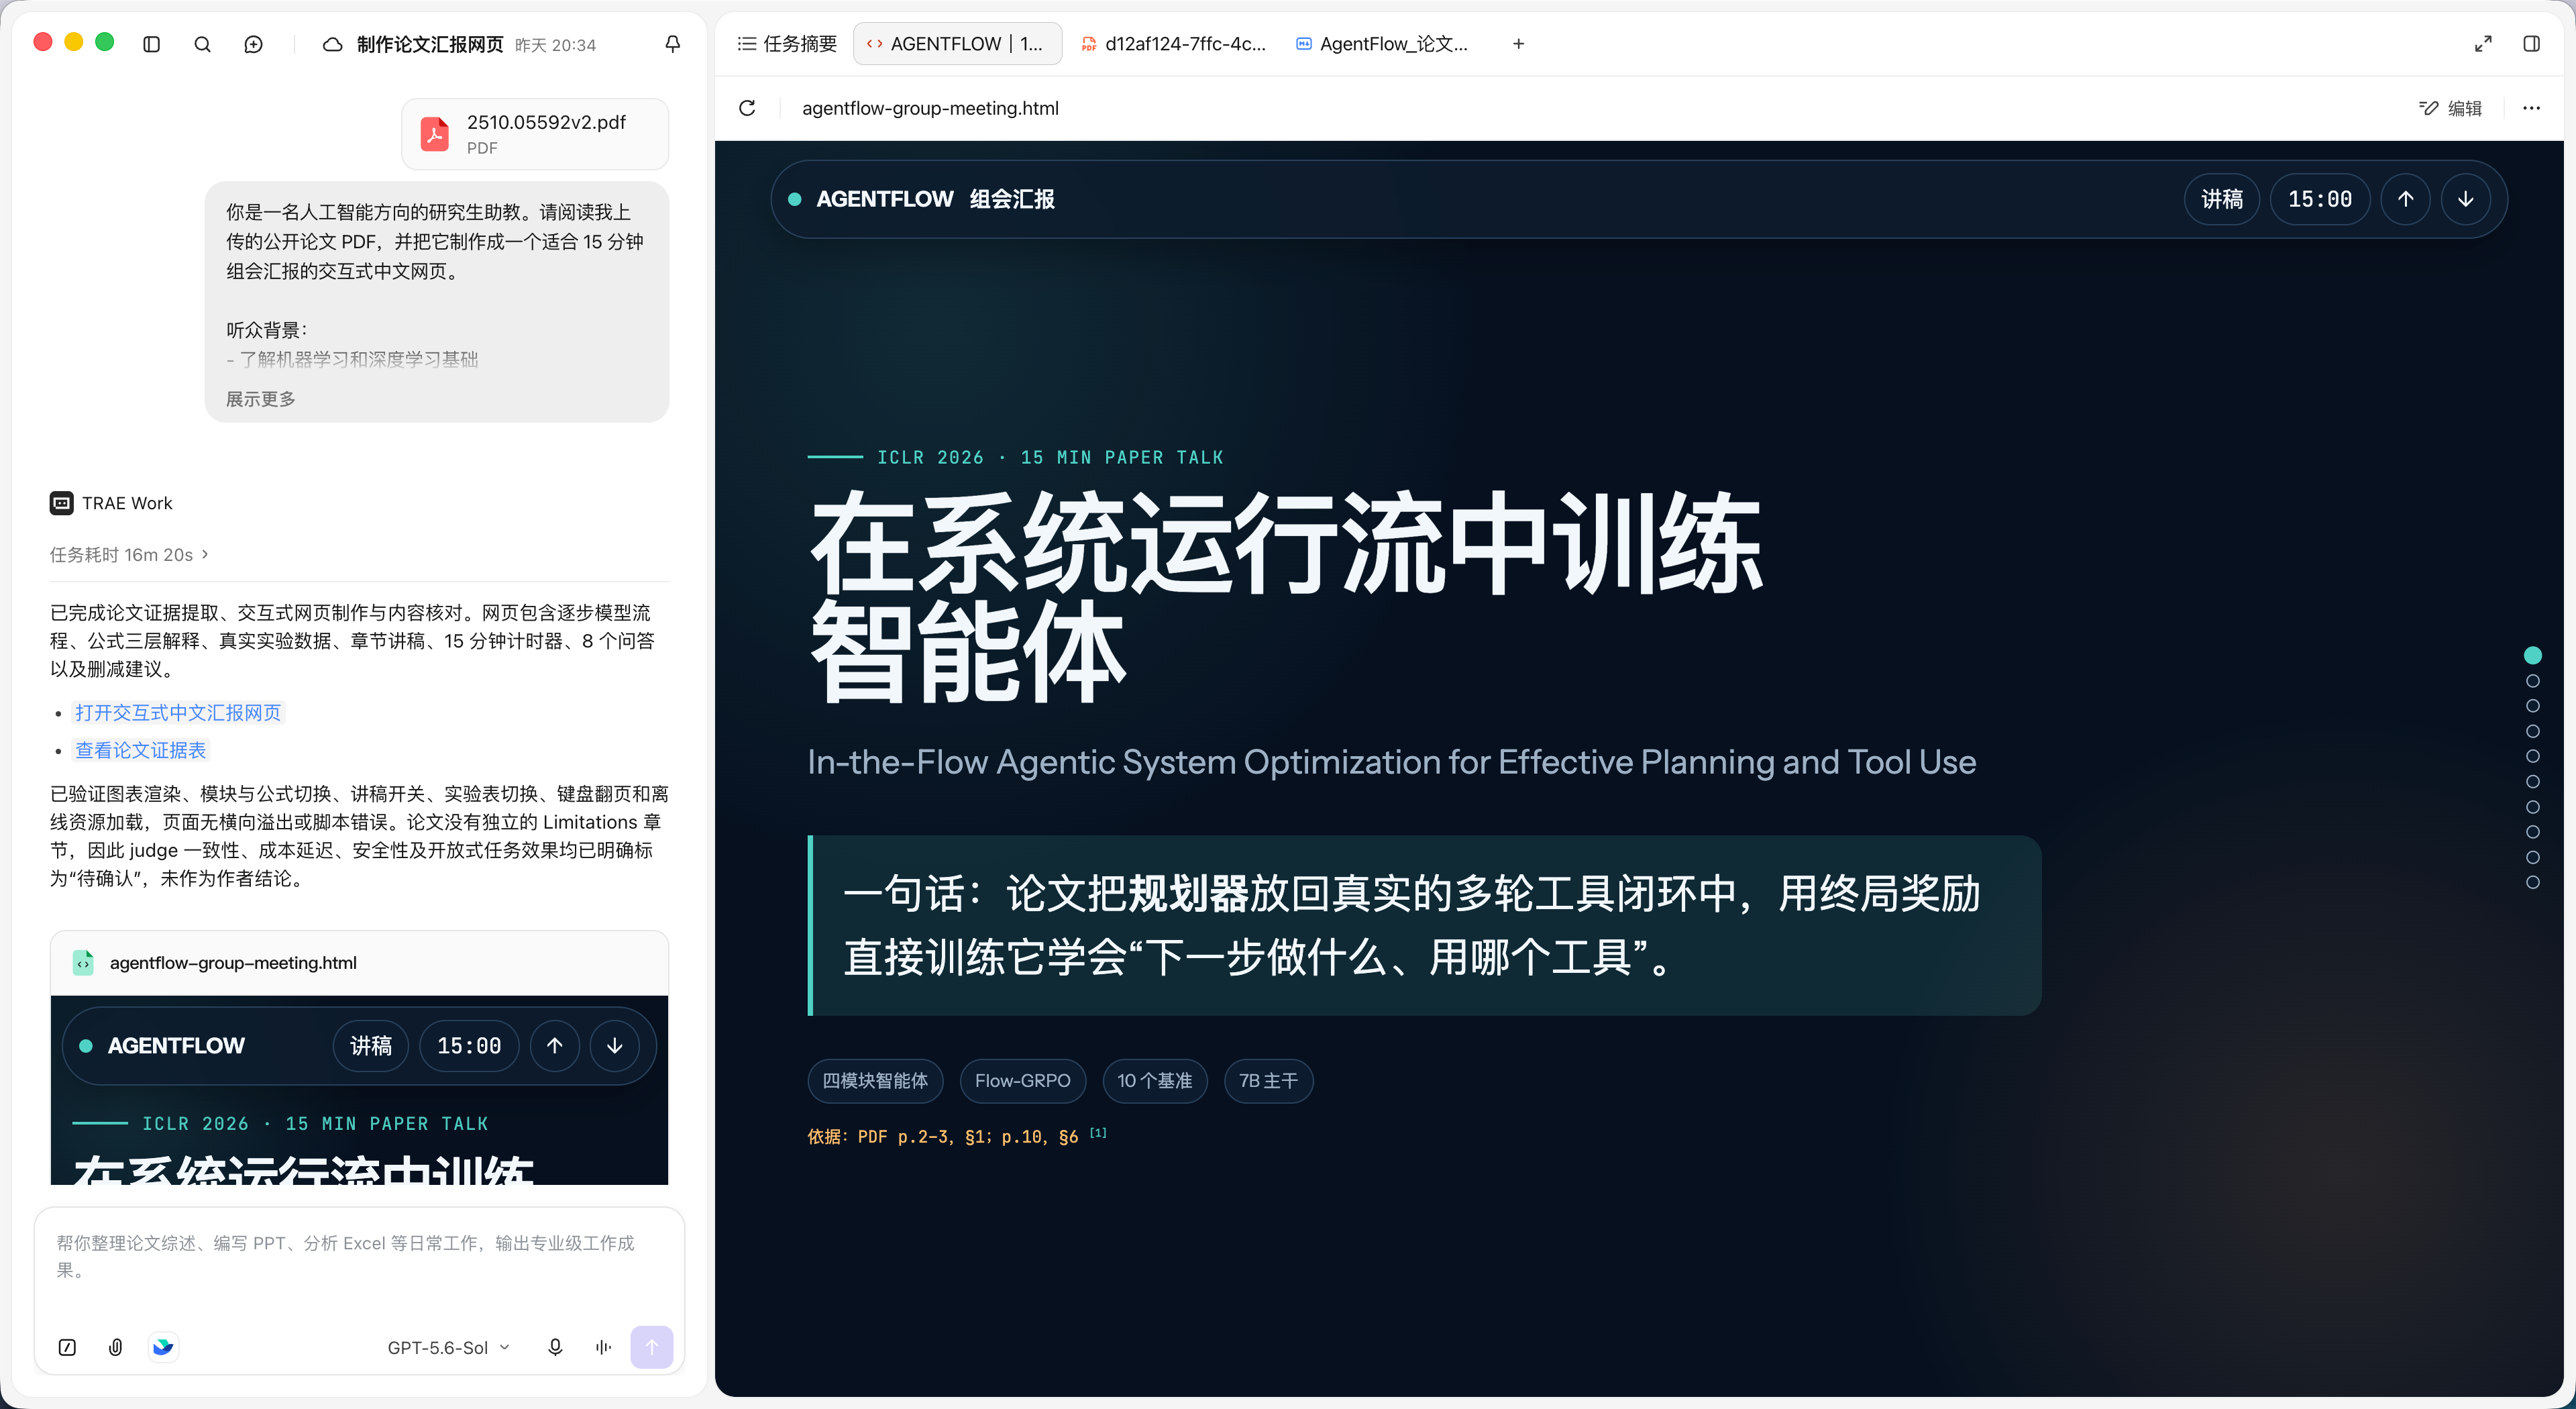
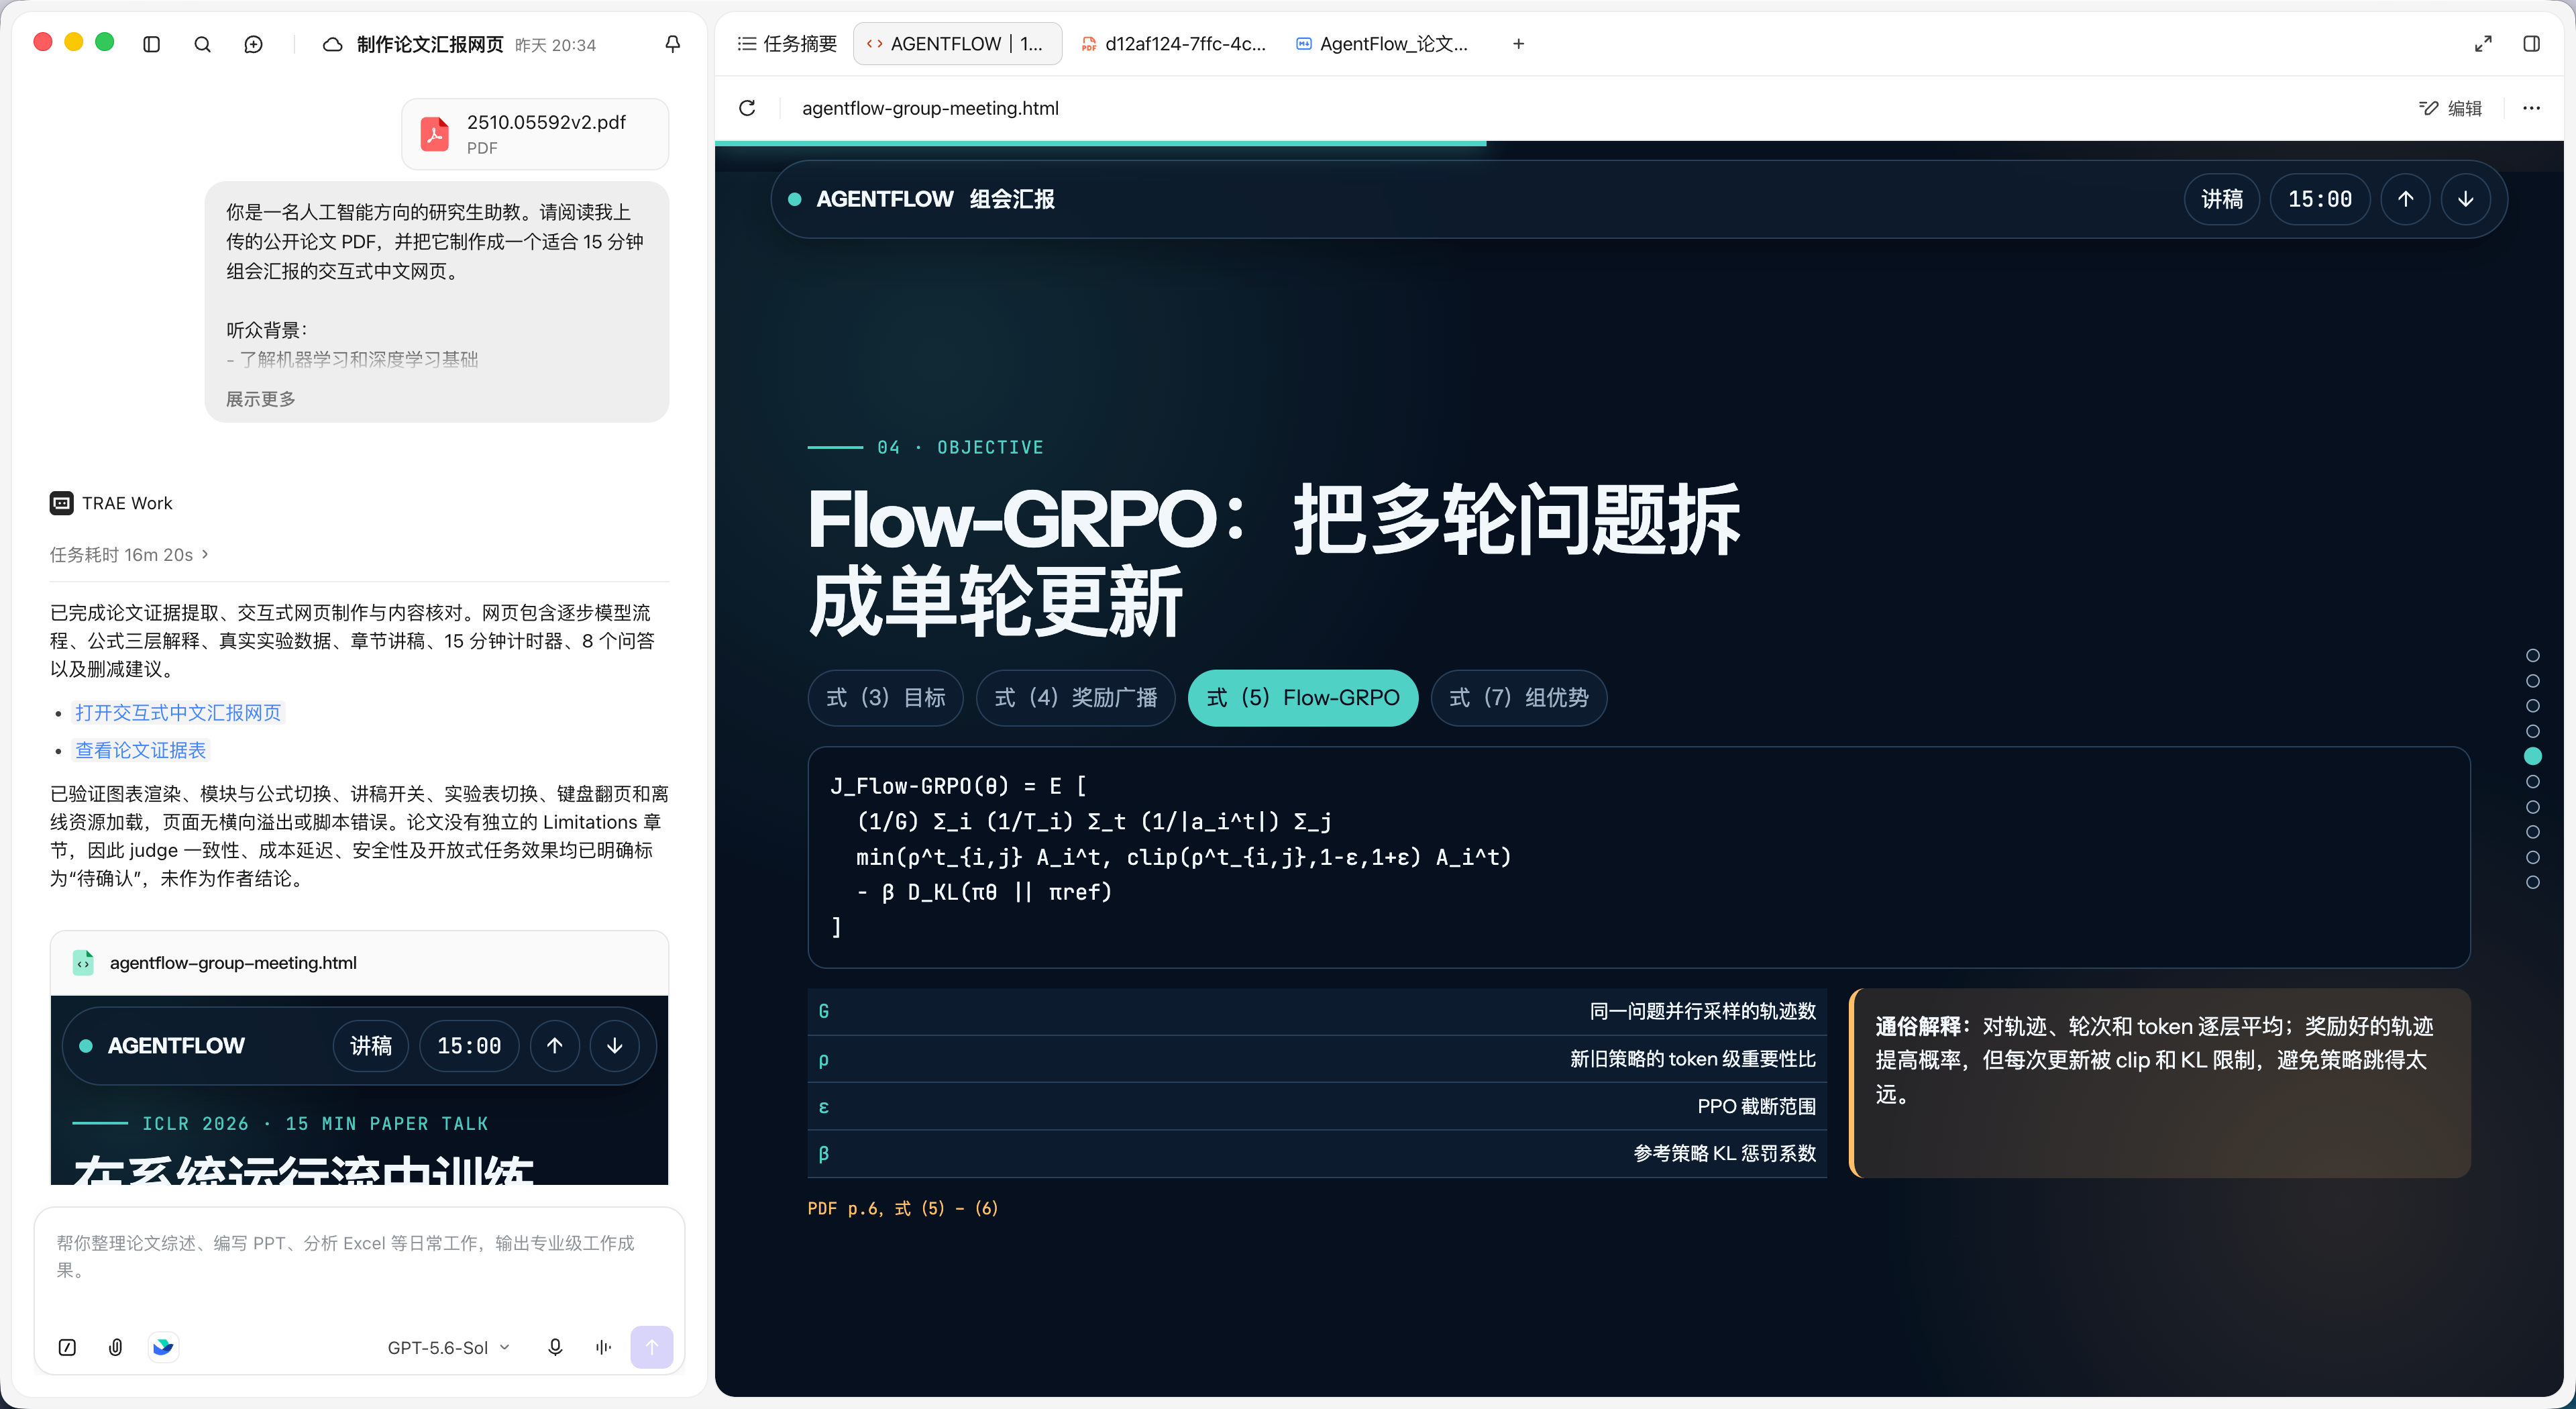
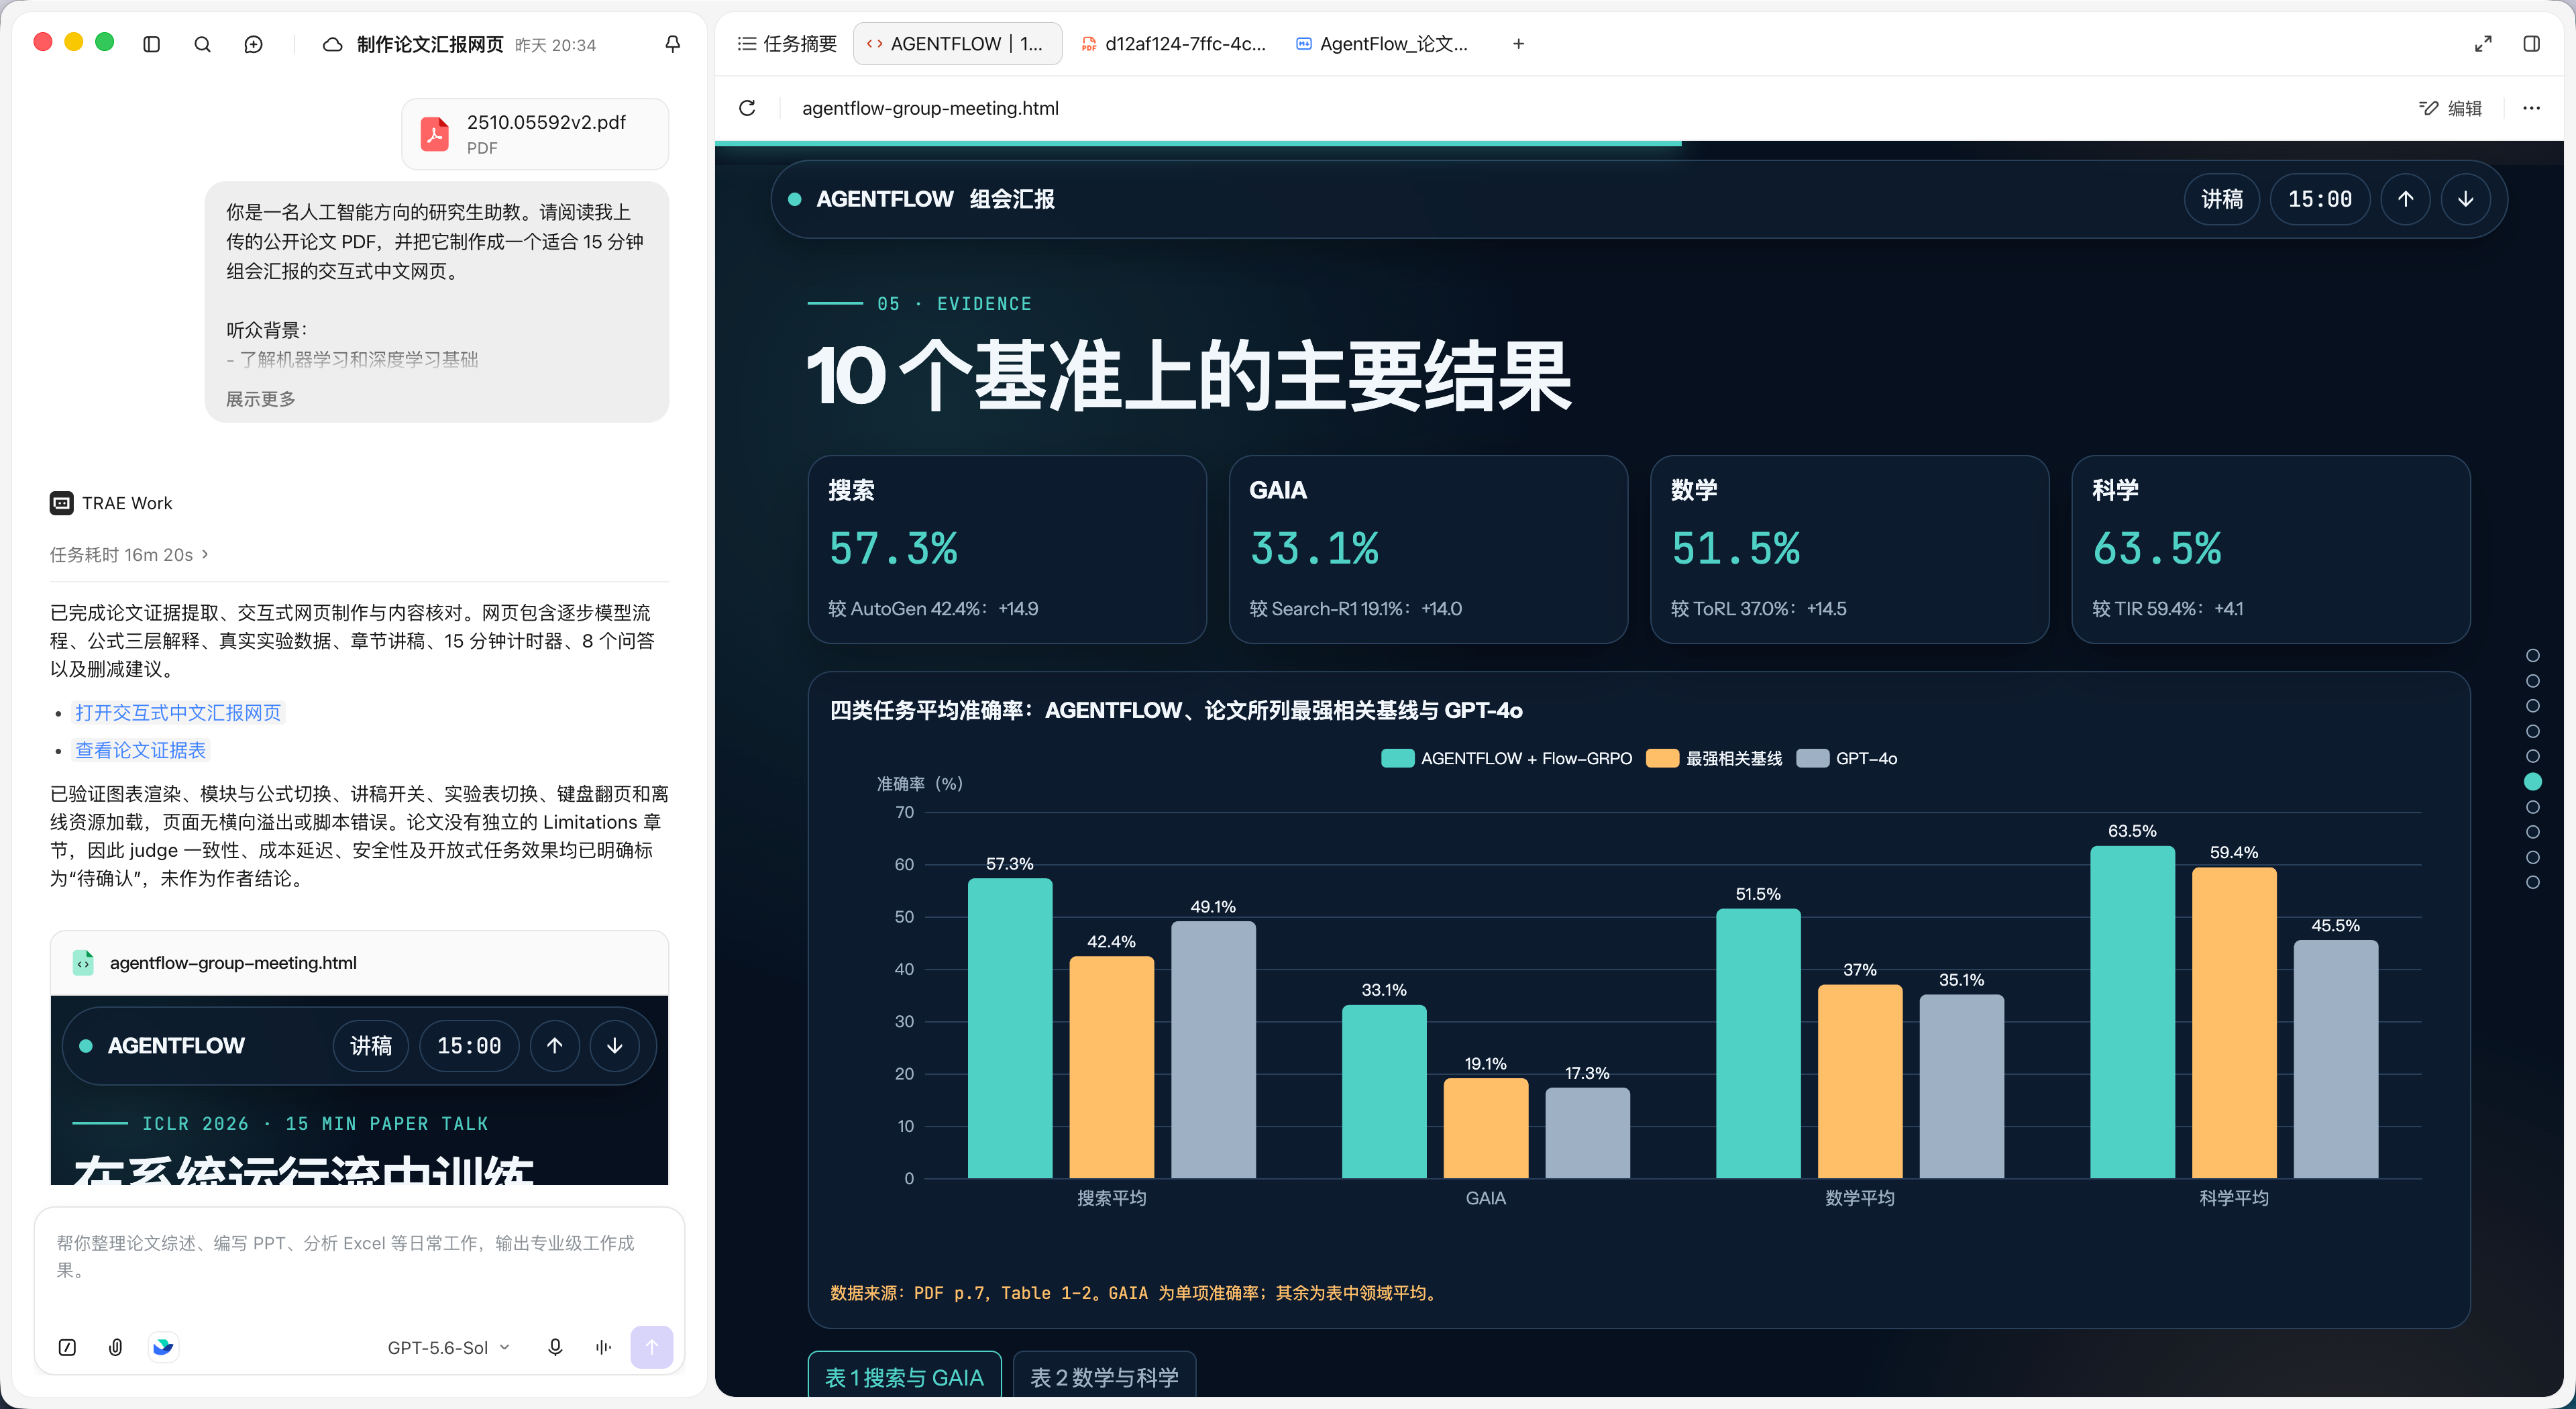
**成果:**一份可直接用于组会展示的交互式论文解读网页:一页看懂、可展开的模型流程图、实验可视化、讲稿和模拟问答。
一、我是谁 & 遇到什么问题
我是 LLM 方向研究生,经常在组会分享论文。准备汇报不只是「看懂摘要」:要梳理动机、读懂结构、核对实验、制作图表、准备讲稿,还要预判提问。论文越长、公式越多,越容易「似乎看懂了,但讲不清楚」。
二、我怎么用 TraeWork 解决
把论文 PDF 和开源仓库链接交给它,先以研究生助教视角拆解,再做成交互式汇报网页。分四步:
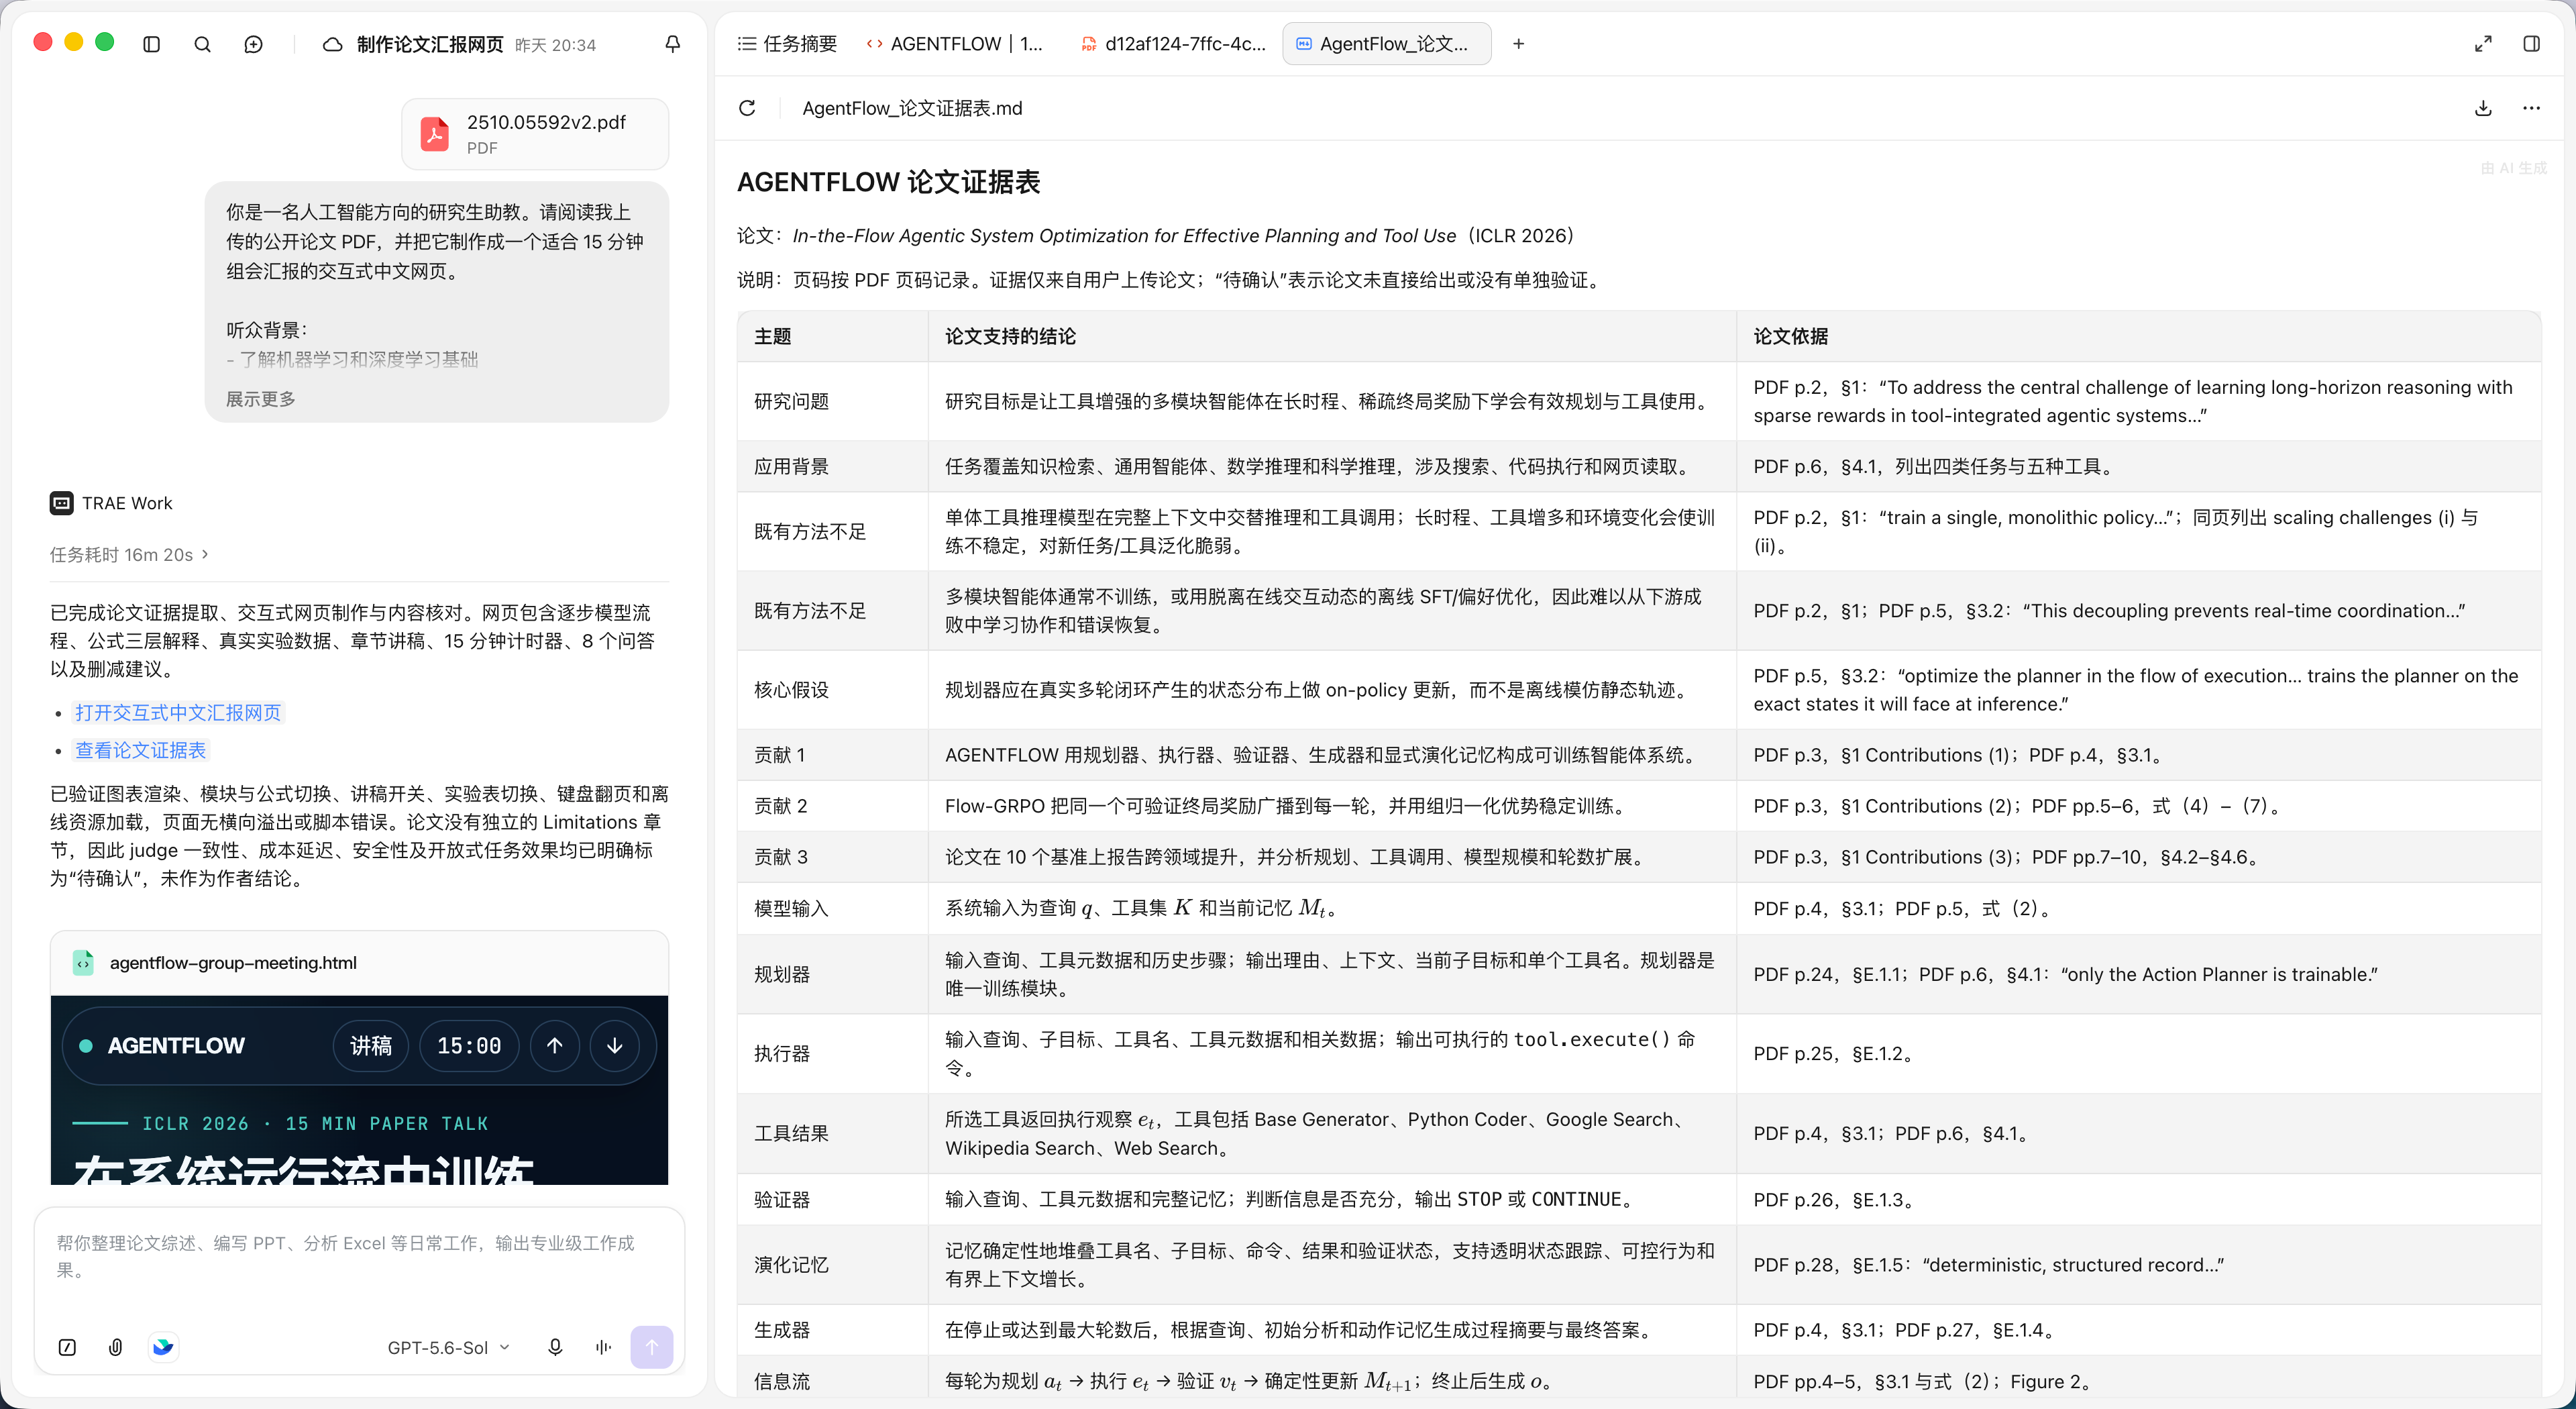
从论文提取研究问题、核心假设、方法结构、实验设置、主要结果和局限,并标注页码;
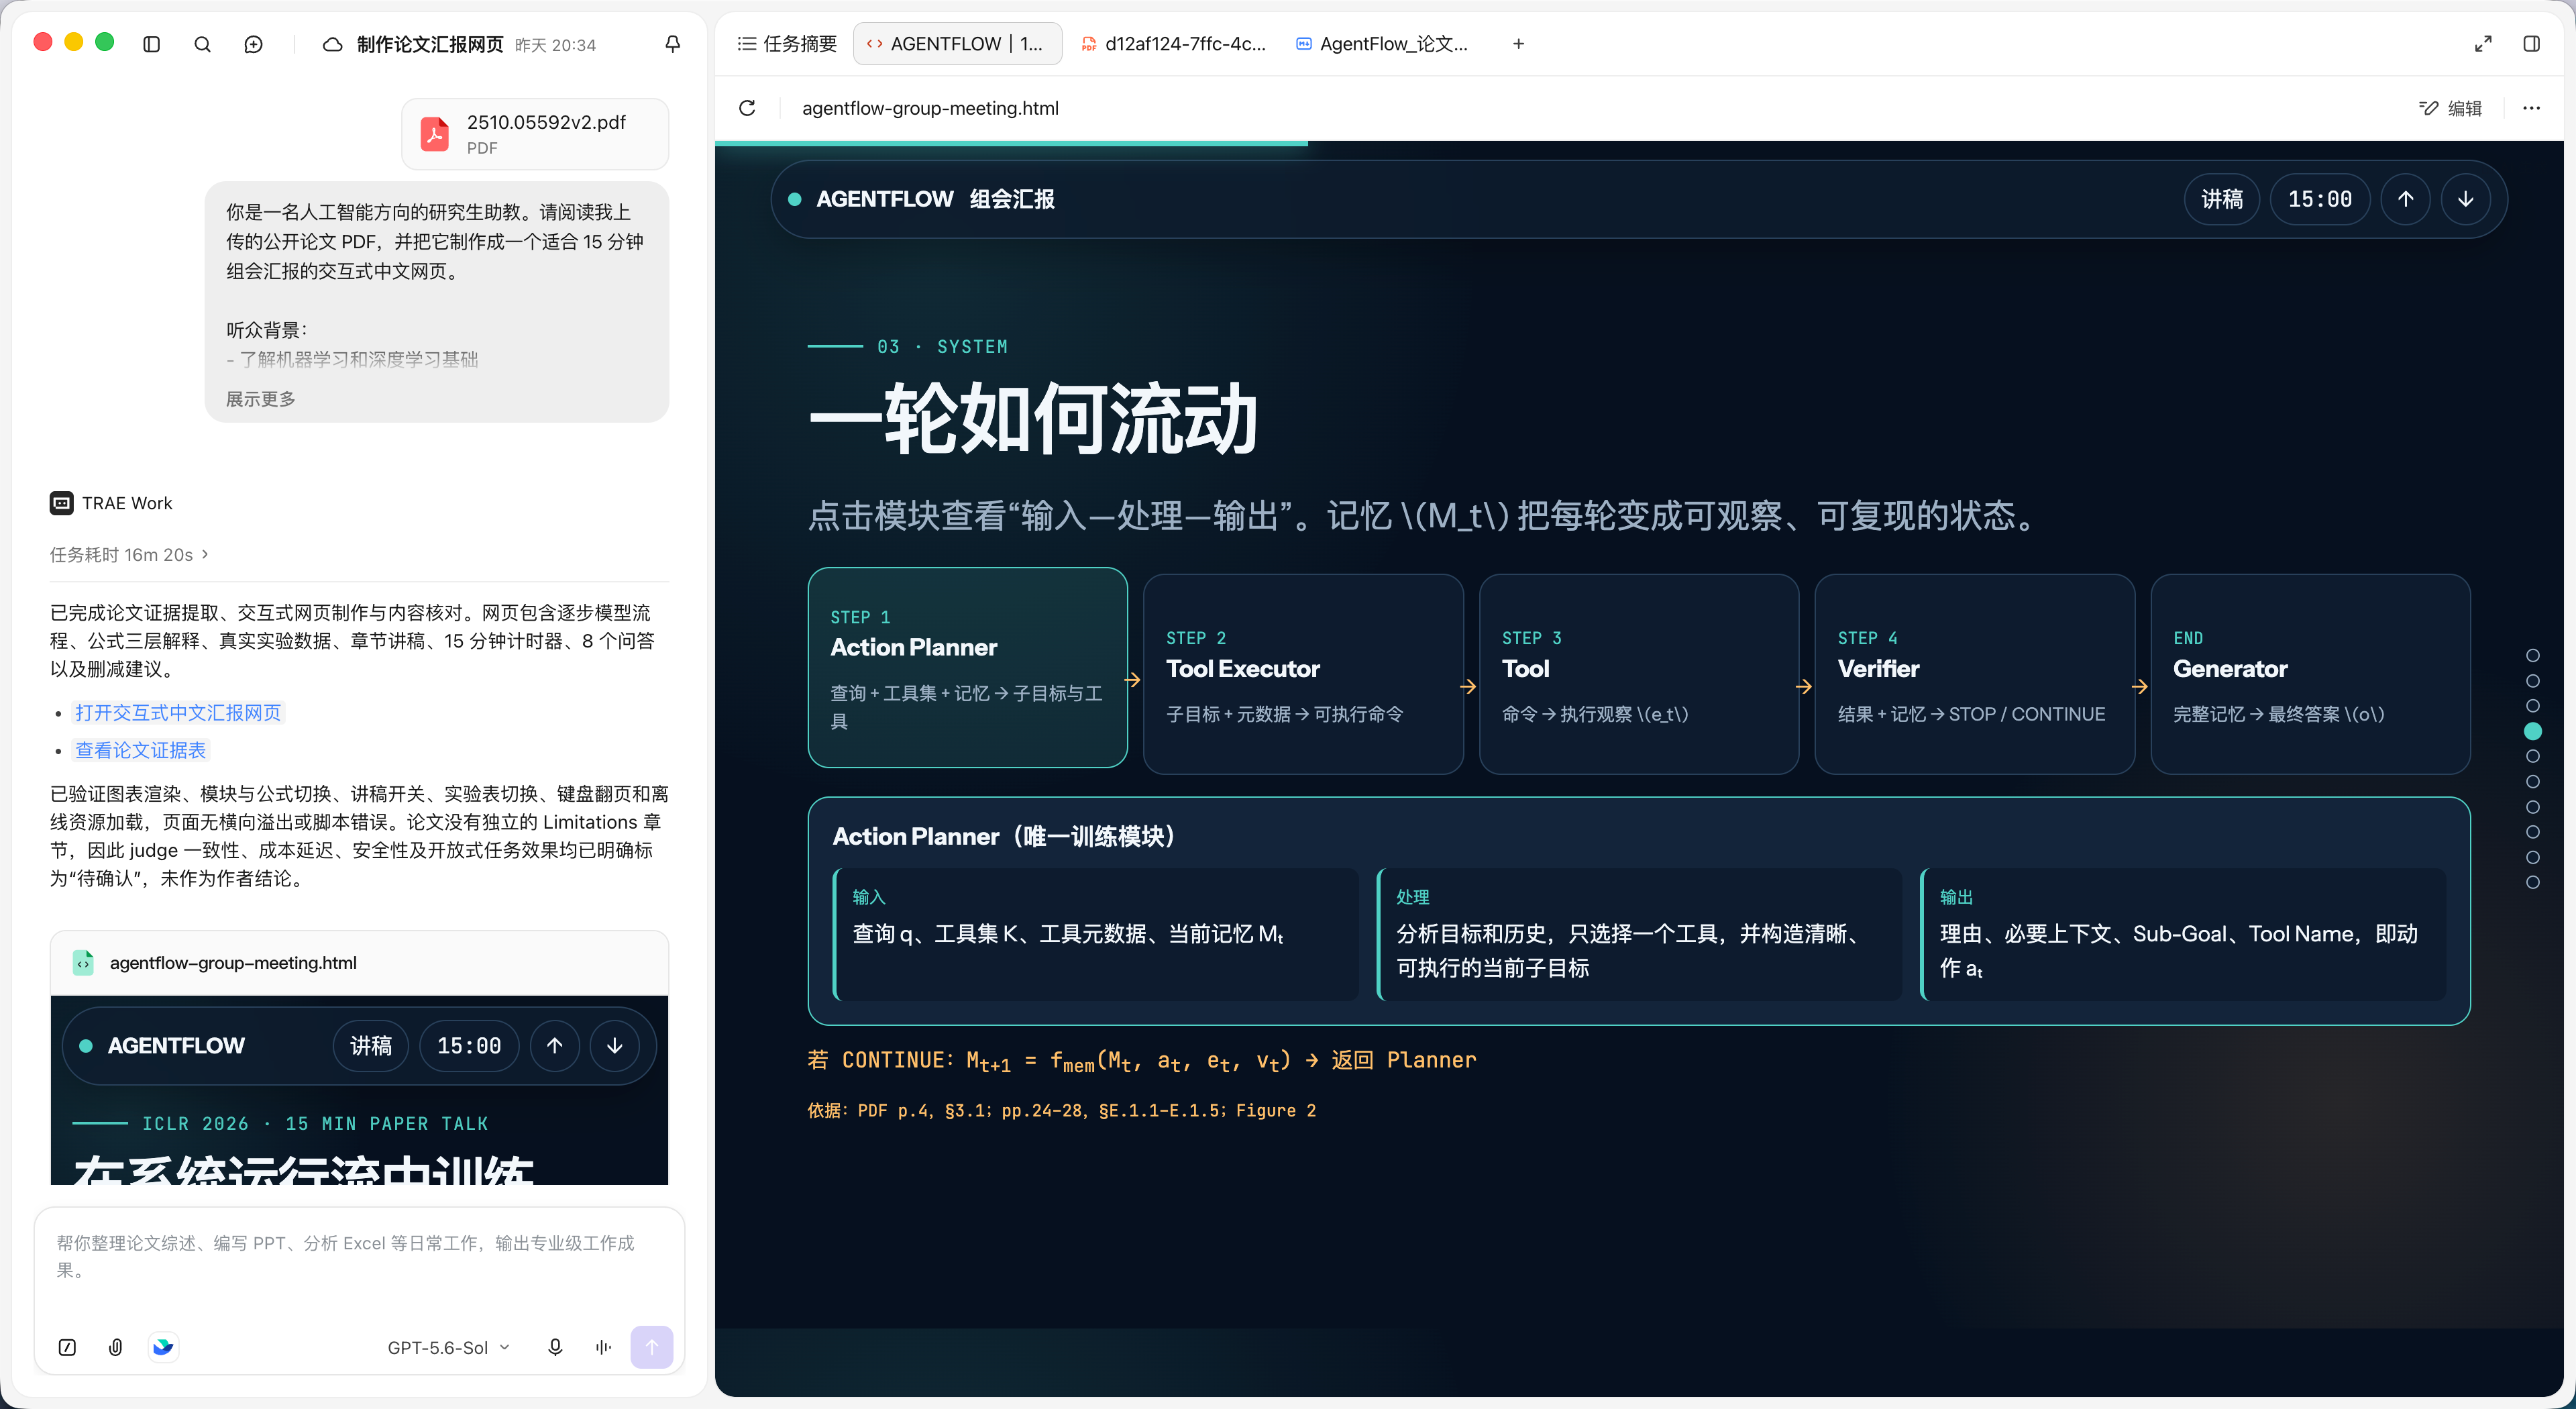
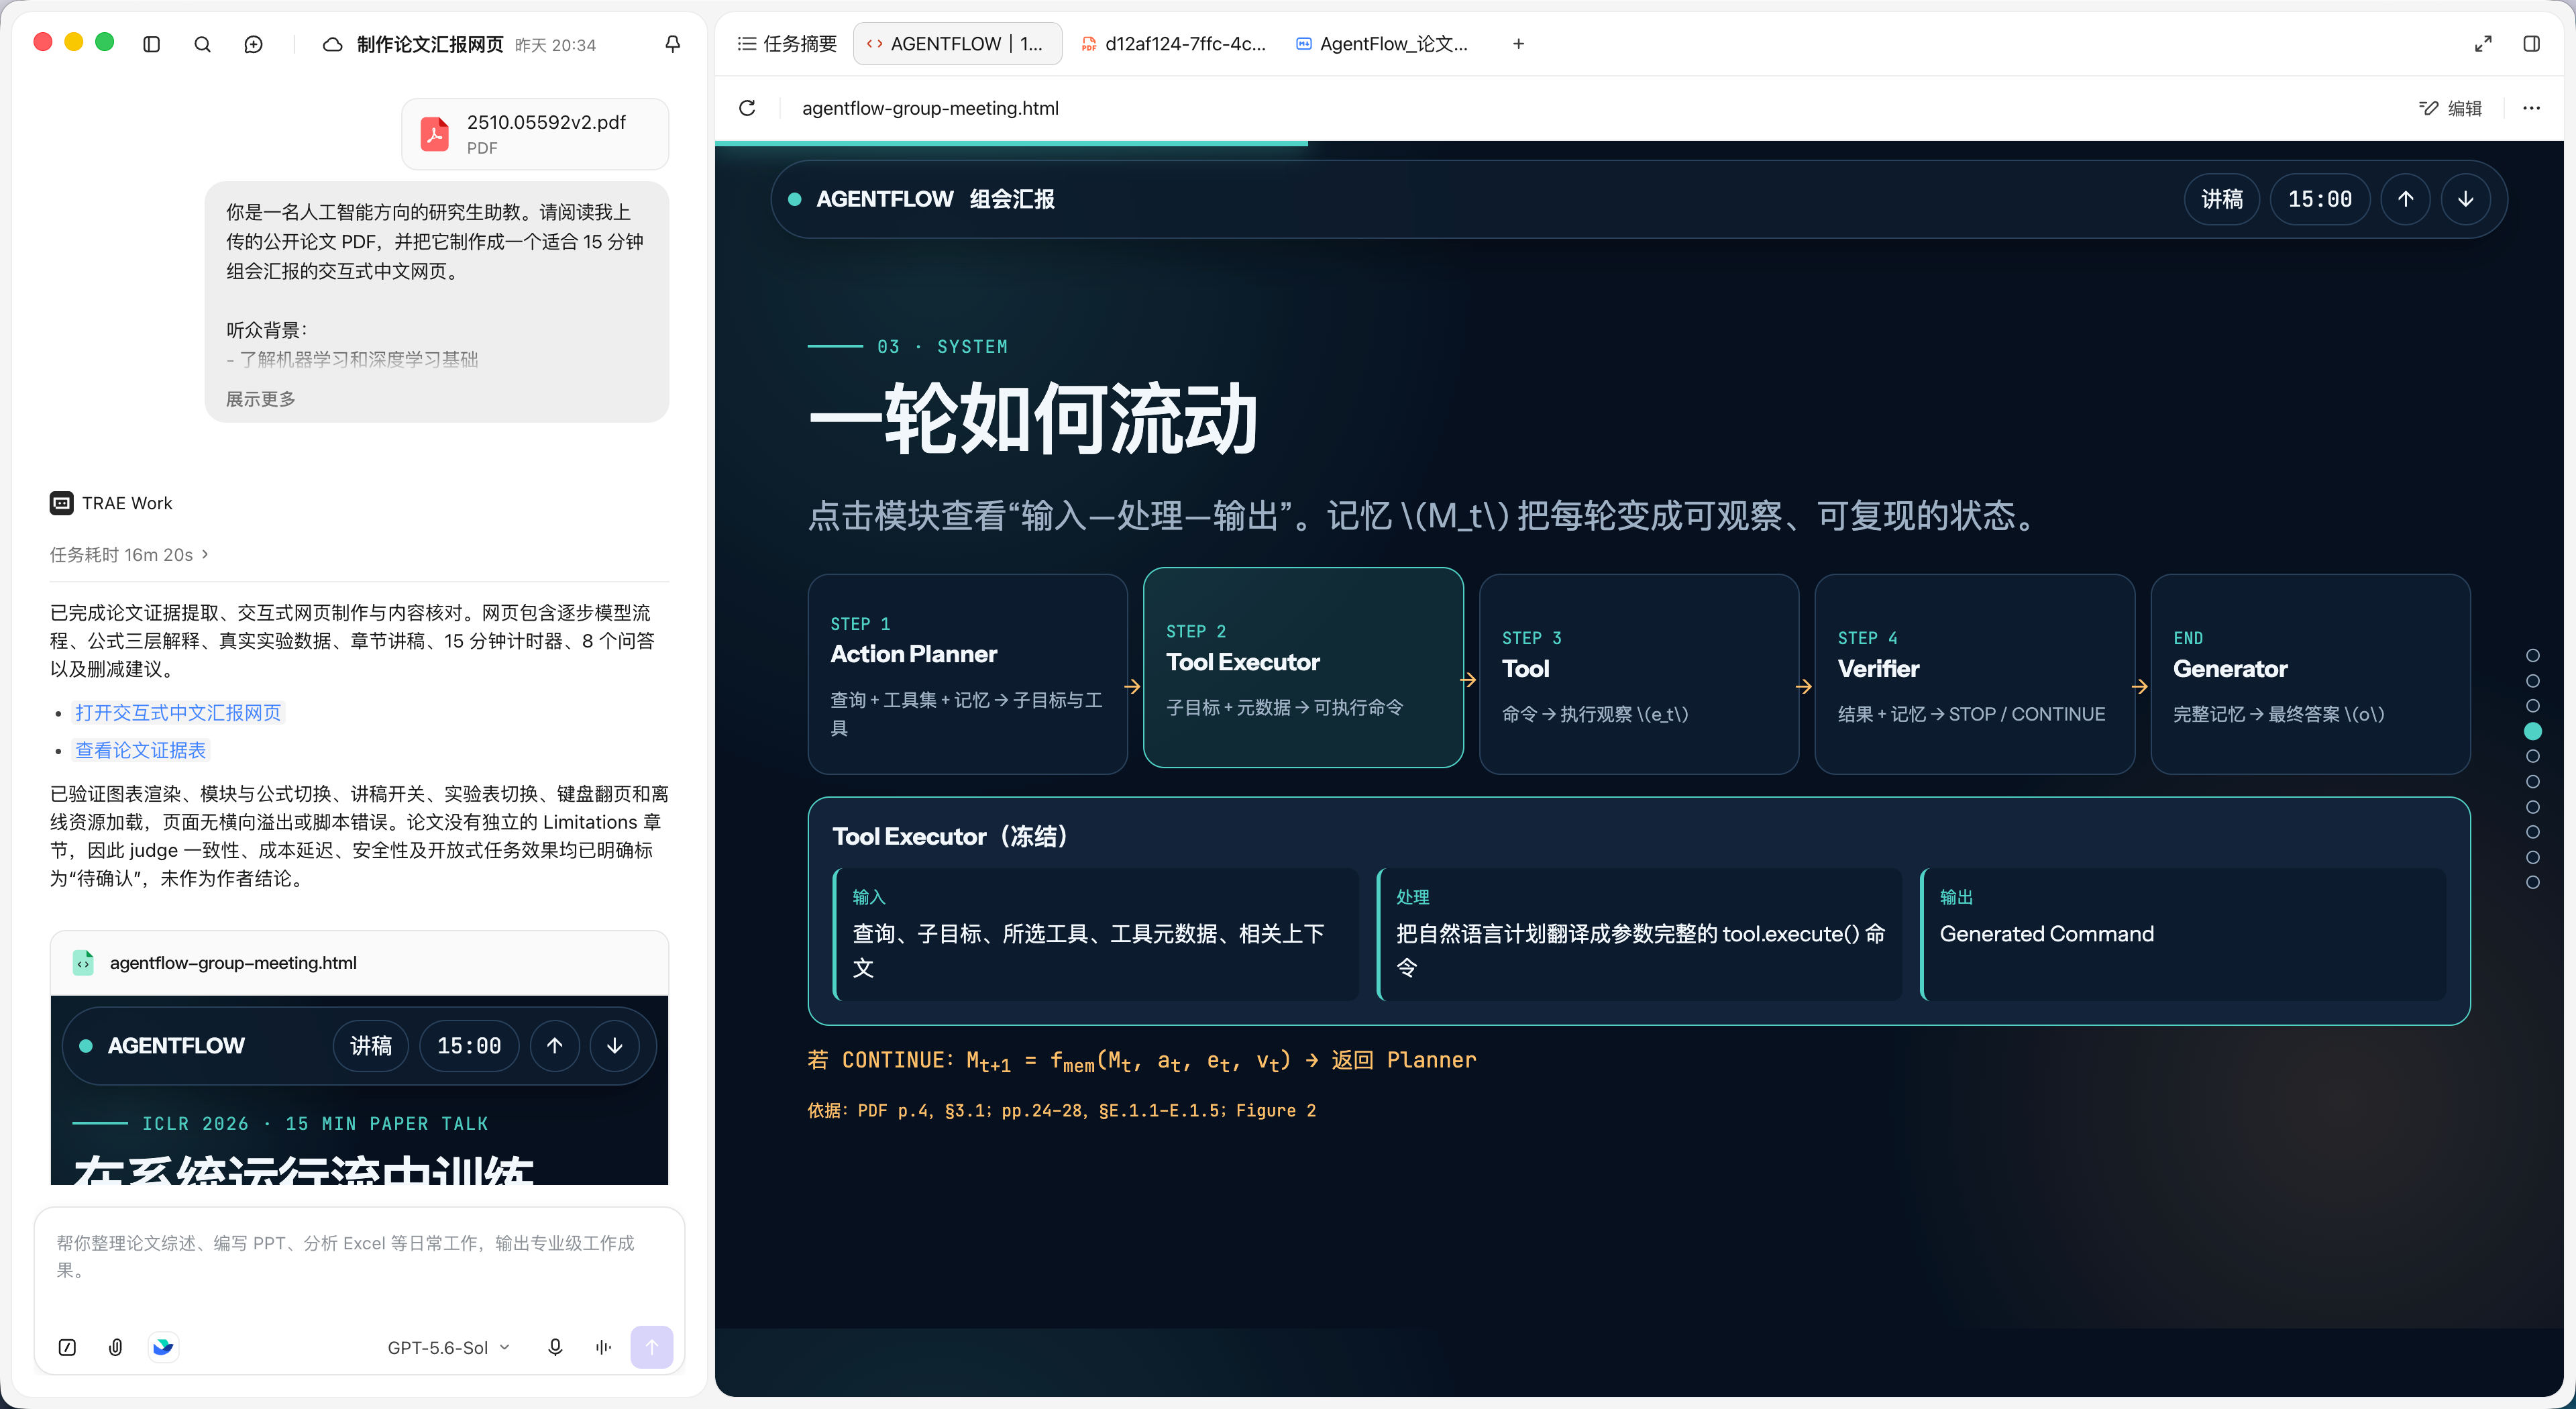
用通俗语言解释关键公式和模块,补充「输入—处理—输出」;
自动绘制方法流程图和实验对比图,将复杂模型拆成可逐步点击的模块;
生成逐页讲稿、可能被追问的问题,以及基于原文的参考回答。
我只需检查引用和关键结论,再按自己的理解修改重点,不用从空白页面开始。
三、我做出了什么
最终呈现:
**主交付物:**一份可直接用于组会展示的交互式论文解读网页:含「一页看懂论文」的研究问题与核心贡献、可逐步展开的模型流程图、实验结果可视化对比、汇报讲稿和模拟问答。原本准备约 1 天,这次到可讲的第一版只用了 16 分钟。
**成果补充:**一份可直接用于组会展示的交互式论文解读网页:一页看懂、可展开的模型流程图、实验可视化、讲稿和模拟问答。
**效率表现:**准备一次汇报原本约 1 天,这次从上传论文到可讲的第一版只用了 16 分钟。
四、效果展示
五、经验 & 技巧总结
**先建立证据表,再生成网页。**要求每条核心结论附论文页码或原文片段,避免网页好看但与原论文不一致。
**明确汇报对象。**提前告诉它听众背景,生成的类比和术语解释会更合适。
**让它暴露不确定性。**论文中没明确说明的内容统一标记为「待确认」,而不是补一个听起来合理的答案。
六、提示词参考
Plain
你是一名人工智能方向的研究生助教。请阅读我上传的公开论文 PDF,
制作成一个适合 15 分钟组会汇报的交互式中文网页。

第一步,先建立论文证据表,提取研究问题、现有方法不足、核心假设与贡献、
模型输入/模块/信息流/输出、训练目标与关键公式、数据集/基线/指标/主要结果、
消融实验与结论、局限与可继续研究的问题;每条重要结论必须附页码或原文片段,
无法确认的信息标记为"待确认",不要自行推测。

第二步,制作自包含 HTML 汇报网页:首页一句话说明论文解决什么问题,
用可逐步展开的流程图解释模型(每模块显示输入-处理-输出),
关键公式给出原公式+符号解释+通俗解释,实验只用论文真实数据并标来源,
每章节配简短讲稿,最后生成 8 个可能被问的问题及基于论文的参考回答。

第三步,做一次内容核对,列出核心结论及其依据、仍需人工确认的内容、可删减部分。
No.63|用 TraeWork 清洗实验数据
作者:推荐算法 / 策略工程师 | 工具:TraeWork(Work + Code)| 阅读约 6 分钟
**用法总结:**用 TraeWork 清洗推荐算法 A/B 实验数据,整理成分群评分、风险收益表和可直接复盘的 Markdown 摘要。
**场景:**A/B 实验复盘,判断某策略在不同人群、参数方向上是否值得推进。
**效率提升:**数据清洗 + 初版分析从半天缩短到 1 小时内,数据量从 1.4w 清洗到 1.3k。
**成果:**一组可直接用于复盘的结果文件:清洗后 CSV、分群评分表、风险收益评分、Markdown 摘要。
一、我是谁 & 遇到什么问题
我做推荐算法 / 策略相关工作,日常看 A/B 实验结果。这类数据经常不是一张干净表:混着实验版本、分群标签、参数方向、收益指标、guardrail 指标和异常值。手动处理时最怕两件事:清洗规则写漏,以及只看整体均值、忽略某些人群里更高的风险。
二、我怎么用 TraeWork 解决
把脱敏后的实验数据交给它,要求它不要直接下结论,而是先做数据质量分析,再做清洗和分群分析,围绕「数据能不能信、哪些人群值得看、证据是否充分」三个问题推进。
| 步骤 | 我给的材料 | TraeWork 做的事 |
|---|---|---|
| 第一步 | 脱敏实验 CSV、分群字段和参数结果 | 浏览字段和样本,判断异常、缺失、重复或口径不一致 |
| 第二步 | A/B 指标和 guardrail 约束 | 按收益、风险、证据强度重新组织清洗规则 |
| 第三步 | 清洗后的中间表 | 生成分群评分、参数方向摘要、风险收益表等结果文件 |
| 第四步 | 分析目标:找出值得关注的人群 | 输出 Markdown 摘要,说明哪些人群值得看、调整方向、证据强弱 |
三、我做出了什么
最终呈现:
**主交付物:**一组可直接用于复盘的结果文件:清洗后 CSV、分群评分表、风险收益评分、Markdown 摘要。
**效率表现:**数据清洗 + 初版分析从半天缩短到 1 小时内,数据量从 1.4w 清洗到 1.3k。
| 产物 | 内容 | 对我的帮助 |
|---|---|---|
| 清洗后的 CSV | 过滤异常值、统一字段、整理分群和参数结果 | 不用再从原始表手动筛选 |
| 分群评分表 | 按人群计算选择分数、guardrail 风险和支持证据 | 更快定位值得重点看的实验人群 |
| Markdown 摘要 | 回答哪些人群值得圈、调整方向、指标变化和证据强弱 | 可直接放进复盘材料二次修改 |
四、经验 & 技巧总结
**先让它做数据体检,再让它清洗。**先检查字段、空值、异常值、重复样本和口径,而不是一上来就要结论。
**指令里要写清「不要编」。**不确定的地方标成待确认,证据不足就说证据不足。
**让它输出文件而非只输出聊天结论。**CSV 和 Markdown 都能复查,方便后续继续改脚本或贴进复盘。
五、提示词参考
Plain
帮我清洗这批推荐算法 A/B 实验数据。请先不要急着给结论,先自己做数据分析,再决定怎么清洗。
请重点检查:
1. 数据是否有空值、重复、异常分群或明显不合理的指标;
2. 实验版本、分群字段、参数方向和基础指标之间是否能对应上;
3. 哪些人群有明确正向收益,哪些人群收益高但 guardrail 风险也高;
4. 证据不足请标成"证据不足",不要替我编结论。
输出两类结果:
- 清洗后的 CSV:分群评分、风险收益评分、参数方向摘要等;
- Markdown summary:只回答哪些人群值得圈、对应调整方向、指标增减、证据强度。
要求:过程可复查,字段命名清楚,结论说人话。来源说明:本文整理自 TraeWork 官方知识库,仅用于个人学习与参考。TraeWork 为字节跳动旗下 AI 办公平台。如涉及版权或官方更新,请以官方发布为准。